

Los modelos de inteligencia artificial ofrecen la capacidad de generar respuestas textuales a una amplia variedad de preguntas, incluidas aquellas relacionadas con temas médicos. Recientemente, han incorporado la posibilidad de interpretar y responder a consultas basadas en imágenes, incluyendo imágenes radiológicas. El objetivo principal del estudio es analizar el rendimiento de ChatGPT-4o frente a estudiantes de tercer año de Medicina en una prueba práctica de la asignatura de Radiología y Medicina Física. Como objetivo secundario pretendemos valorar la capacidad de ChatGPT para interpretar imágenes médicas y responder a preguntas sobre las mismas.
Material y métodosSe examinó a un grupo de 33 estudiantes con 10 preguntas sobre imágenes radiológicas y de medicina nuclear. El mismo examen se administró a ChatGPT (versión GPT-4o) sin entrenamiento previo, siguiendo un formato idéntico. Las respuestas al examen fueron evaluadas por profesores que desconocían qué examen correspondía al modelo a prueba. Se utilizó la prueba U de Mann-Whitney para comparar los resultados entre los 2 grupos.
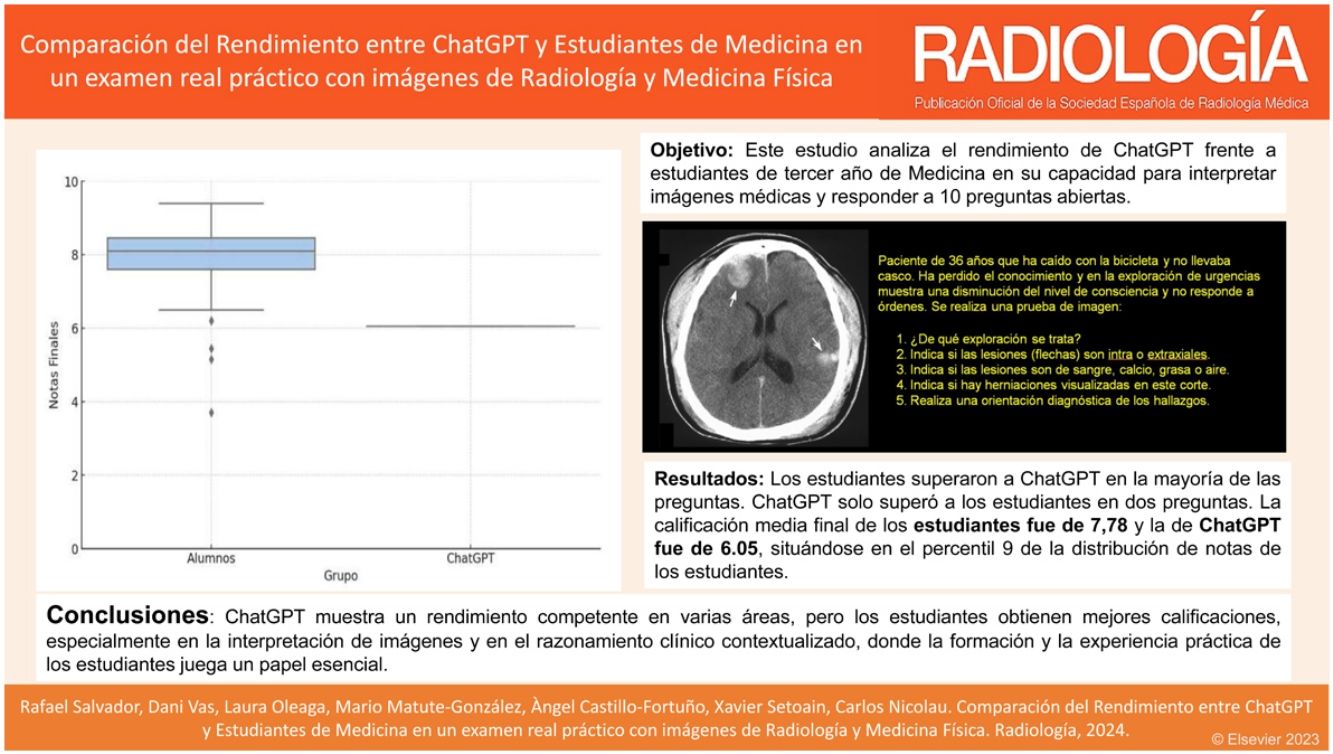
ResultadosLos estudiantes superaron a ChatGPT en 8 preguntas. La calificación media final de los estudiantes fue de 7,78 y la de ChatGPT fue de 6,05, situándose en el percentil 9 de la distribución de notas de los estudiantes.
DiscusiónChatGPT muestra un rendimiento competente en varias áreas, pero los estudiantes obtienen mejores calificaciones, especialmente en la interpretación de imágenes y en el razonamiento clínico contextualizado, donde la formación y la experiencia práctica de los estudiantes juegan un papel esencial. Son necesarias todavía mejoras en los modelos de inteligencia artificial para alcanzar la capacidad humana de interpretar imágenes radiológicas e integrar información clínica.
Artificial intelligence models can provide textual answers to a wide range of questions, including medical questions. Recently, these models have incorporated the ability to interpret and answer image-based questions, and this includes radiological images. The main objective of this study is to analyse the performance of ChatGPT-4o compared to third-year medical students in a Radiology and Applied Physics in Medicine practical exam. We also intend to assess the capacity of ChatGPT to interpret medical images and answer related questions.
Materials and methodThirty-three students set an exam of 10 questions on radiological and nuclear medicine images. Exactly the same exam in the same format was given to ChatGPT (version GPT-4o) without prior training. The exam responses were evaluated by professors who were unaware of which exam corresponded to which respondent type. The Mann-Whitney U test was used to compare the results of the 2 groups.
ResultsThe students outperformed ChatGPT on 8 questions. The students’ average final score was 7.78, while ChatGPT's was 6.05, placing it in the 9th percentile of the students’ grade distribution.
DiscussionChatGPT demonstrates competent performance in several areas, but students achieve better grades, especially in the interpretation of images and contextualised clinical reasoning, where students’ training and practical experience play an essential role. Improvements in artificial intelligence models are still needed to achieve human-like capabilities in interpreting radiological images and integrating clinical information.

El uso y adopción de los modelos de lenguaje de gran escala, como ChatGPT, no tiene precedentes. Este modelo que usa la inteligencia artificial (IA) para generar respuestas contextualizadas y basadas en el entrenamiento con millones de entradas tiene el potencial de transformar diversos ámbitos, incluyendo la medicina y la educación médica, y se encuentra entre los temas más discutidos y comentados en la actualidad debido a su capacidad de revolucionar la forma en que se accede y se utiliza la información en estos campos1,2.
En 2022 se publicaron 4 artículos indexados en PubMed con la palabra ChatGPT, en 2023 el número de publicaciones aumentó significativamente a 2.082, y a 7 de agosto de 2024 ya se han publicado 2.261 artículos3.
El 13 de mayo de 2024 se lanzó la última versión iterativa de ChatGPT, la versión 4-Omni (GPT-4o), que representa un avance significativo respecto a modelos anteriores puesto que integra capacidades multimodales que permiten gestionar y generar resultados a partir de texto, audio e imágenes4,5. GTP-4o mejora la velocidad de respuesta y la eficiencia, además de aumentar las capacidades en idiomas diferentes del inglés. Los modelos anteriores podían interpretar imágenes a partir de entradas de texto que las describieran, hasta que en septiembre de 2023 salió la versión GPT-4V, con la V por su capacidad visual de interpretar imágenes, incluidas las imágenes radiológicas6. Sin embargo, la última versión presenta una mejora en la precisión de la interpretación de imágenes radiológicas, con respuestas más rápidas y la capacidad de poder interpretar las imágenes a partir de fotos o capturas de pantalla de distintos dispositivos. Ya se ha valorado su utilidad y el rendimiento en exámenes del ámbito médico, pero se ha estudiado únicamente el rendimiento en las preguntas de razonamiento o respuesta múltiple basadas en casos clínicos, sin imágenes médicas7–13.
En la carrera universitaria del grado de Medicina de nuestra institución, los estudiantes cursan la asignatura de Radiología y Medicina Física en el tercer año de su programa formativo que dura 6 años. Reciben clases teóricas, seminarios prácticos y realizan unas prácticas tuteladas por los servicios de Radiología, Medicina Nuclear, Radioterapia y Rehabilitación del hospital. Posteriormente, se les evalúa con una prueba práctica y otra teórica. En el examen práctico deben responder a preguntas cortas sobre unas imágenes que se les muestran (material suplementario).
La capacidad de ChatGPT para interpretar y responder a preguntas basadas en imágenes médicas se pone a prueba frente a la formación y el conocimiento práctico de los estudiantes.
Los objetivos del estudio son evaluar la precisión de ChatGPT en la interpretación de imágenes radiológicas y de medicina nuclear y comparar la capacidad de respuesta de ChatGPT con la de los estudiantes de Medicina en preguntas sobre interpretación de imágenes.
Material y métodosSe realizó un estudio comparativo en un grupo de 37 estudiantes de tercer año de la asignatura de Radiología y Medicina Física de la Universidad de Barcelona. El estudio fue aprobado por el Comité de Ética de la Investigación con medicamentos del Hospital Clínic de Barcelona.
EstudiantesLos 37 alumnos formaban parte del segundo grupo del total de 77 alumnos matriculados para el segundo semestre de dicha asignatura. Se trataba del último grupo a evaluar de manera ordinaria en la asignatura. Se les evaluó al finalizar sus sesiones prácticas y teóricas de la asignatura, antes del examen final teórico. Al finalizar el examen se les informó del desarrollo del estudio y se les solicitó consentimiento informado para su participación en el mismo, que concedieron 33 de los estudiantes, que fueron los únicos incluidos en la comparación.
Examen prácticoComo parte de su evaluación práctica se les plantearon 10 preguntas que incluían la descripción e interpretación de imágenes radiológicas y de medicina nuclear, y la descripción de aparatos de medicina física. Las preguntas fueron planteadas por los mismos profesores que habían dado las prácticas de la asignatura. El examen contenía 7 preguntas de radiología, de diferentes áreas, numeradas del 1 al 7 por este orden: tórax (radiografía), neuro (TC), mama (mamografía), musculoesquelético (radiografía), genitourinario (ecografía y TC) y 2 de abdomen (TC y RM). Dos preguntas eran de medicina nuclear (gammagrafía de ventilación-perfusión y PET-TC) y una última de radioterapia (dispositivos de radioterapia).
No se registró el tiempo empleado por cada alumno en cada pregunta.
Realización del examenSe presentaron en un aula las 10 preguntas proyectadas una a una como diapositivas y los alumnos disponían de 5min para responder a cada pregunta, sin poder retroceder en la presentación.
La noche anterior al examen de los alumnos, se pasó el mismo examen a GPT-4o, sin entrenamiento previo. Se le presentaron las 10 preguntas en el mismo formato utilizado para los alumnos, cada pregunta se mostró en una diapositiva con la imagen y las preguntas asociadas.
La versión utilizada para el estudio es la conocida técnicamente como GPT-4 Turbo (2023), con actualización de contenidos hasta finales de 2023.
El prompt con las indicaciones que debía seguir para responder era el siguiente: «Eres un estudiante de Medicina y debes responder a las siguientes preguntas de un examen práctico de Radiología y Medicina Física General. Debes dar respuestas cortas que respondan a las preguntas que aparecen en texto a partir de las imágenes que se proporcionan en la misma diapositiva. Puedes responder en castellano o catalán. Las respuestas han de ser muy cortas, sin descripción ni explicación a menos que se solicite. Debes intentar sacar la mejor nota posible».
Se le pidió a continuación que indicara cuánto tiempo le llevaría responder cada pregunta si fuera un estudiante de Medicina y cuánto tiempo le llevó procesar cada pregunta como IA.
La respuesta para cada pregunta se pasó en el momento del examen a una hoja de respuestas, escrita a mano por uno de los autores, copiando sin modificación alguna el texto generado por la aplicación y con datos falsos de número identificativo y nombre del alumno.
Evaluación del examenLos exámenes fueron corregidos por los profesores, de los cuales 8 de 10 desconocían la realización del estudio y los otros 2 evitaron a conciencia cualquier tipo de sesgo en la corrección de este y desconocían qué examen fue contestado por el modelo GPT-4o. Se puntuaba cada pregunta con un valor de 0 a 1, sin posibilidad de valoración negativa. La nota final es el resultado de la suma de la nota para cada una de las 10 preguntas, siendo a partir de un 5 un resultado de aprobado. La nota final de la asignatura para los estudiantes otorga un peso del 40% a la nota del examen práctico que se ha evaluado en este estudio.
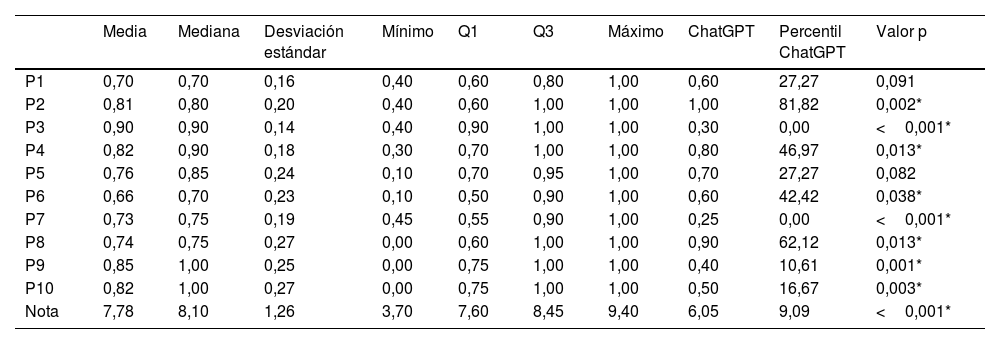
Análisis estadísticoSe realizó un análisis descriptivo de los resultados con medidas de tendencia central y dispersión, que se recogen en la tabla 1, comparando los resultados del grupo de alumnos con el de ChatGPT, valorando los resultados para cada pregunta, así como para la nota final. Se obtuvo el percentil al que correspondía la respuesta de ChatGPT respecto a las respuestas de los alumnos.
Resumen de los resultados para cada pregunta
| Media | Mediana | Desviación estándar | Mínimo | Q1 | Q3 | Máximo | ChatGPT | Percentil ChatGPT | Valor p | |
|---|---|---|---|---|---|---|---|---|---|---|
| P1 | 0,70 | 0,70 | 0,16 | 0,40 | 0,60 | 0,80 | 1,00 | 0,60 | 27,27 | 0,091 |
| P2 | 0,81 | 0,80 | 0,20 | 0,40 | 0,60 | 1,00 | 1,00 | 1,00 | 81,82 | 0,002* |
| P3 | 0,90 | 0,90 | 0,14 | 0,40 | 0,90 | 1,00 | 1,00 | 0,30 | 0,00 | <0,001* |
| P4 | 0,82 | 0,90 | 0,18 | 0,30 | 0,70 | 1,00 | 1,00 | 0,80 | 46,97 | 0,013* |
| P5 | 0,76 | 0,85 | 0,24 | 0,10 | 0,70 | 0,95 | 1,00 | 0,70 | 27,27 | 0,082 |
| P6 | 0,66 | 0,70 | 0,23 | 0,10 | 0,50 | 0,90 | 1,00 | 0,60 | 42,42 | 0,038* |
| P7 | 0,73 | 0,75 | 0,19 | 0,45 | 0,55 | 0,90 | 1,00 | 0,25 | 0,00 | <0,001* |
| P8 | 0,74 | 0,75 | 0,27 | 0,00 | 0,60 | 1,00 | 1,00 | 0,90 | 62,12 | 0,013* |
| P9 | 0,85 | 1,00 | 0,25 | 0,00 | 0,75 | 1,00 | 1,00 | 0,40 | 10,61 | 0,001* |
| P10 | 0,82 | 1,00 | 0,27 | 0,00 | 0,75 | 1,00 | 1,00 | 0,50 | 16,67 | 0,003* |
| Nota | 7,78 | 8,10 | 1,26 | 3,70 | 7,60 | 8,45 | 9,40 | 6,05 | 9,09 | <0,001* |
P1 a P10: preguntas 1 a 10; Q1: cuartil 1; Q3: cuartil 3.
Para el análisis estadístico se empleó la prueba U de Mann-Whitney, una prueba estadística no paramétrica utilizada para evaluar si existe una diferencia significativa entre las distribuciones de 2 grupos independientes. Esta prueba se seleccionó debido a la naturaleza de los datos, el tamaño muestral pequeño, la asimetría en el tamaño del grupo de alumnos (33) con ChatGPT (uno) y la necesidad de comparar 2 grupos independientes (ChatGPT y estudiantes).
El análisis estadístico se realizó utilizando Python versión 3.9 (Python Software Foundation) con la librería SciPy versión 1.7.314, la cual proporciona funciones consistentes para la realización de pruebas estadísticas no paramétricas14. Se considera una diferencia estadísticamente significativa un valor de p inferior a 0,05.
El análisis descriptivo, estadístico y los gráficos se obtuvieron mediante copilotaje con ChatGPT-4o.
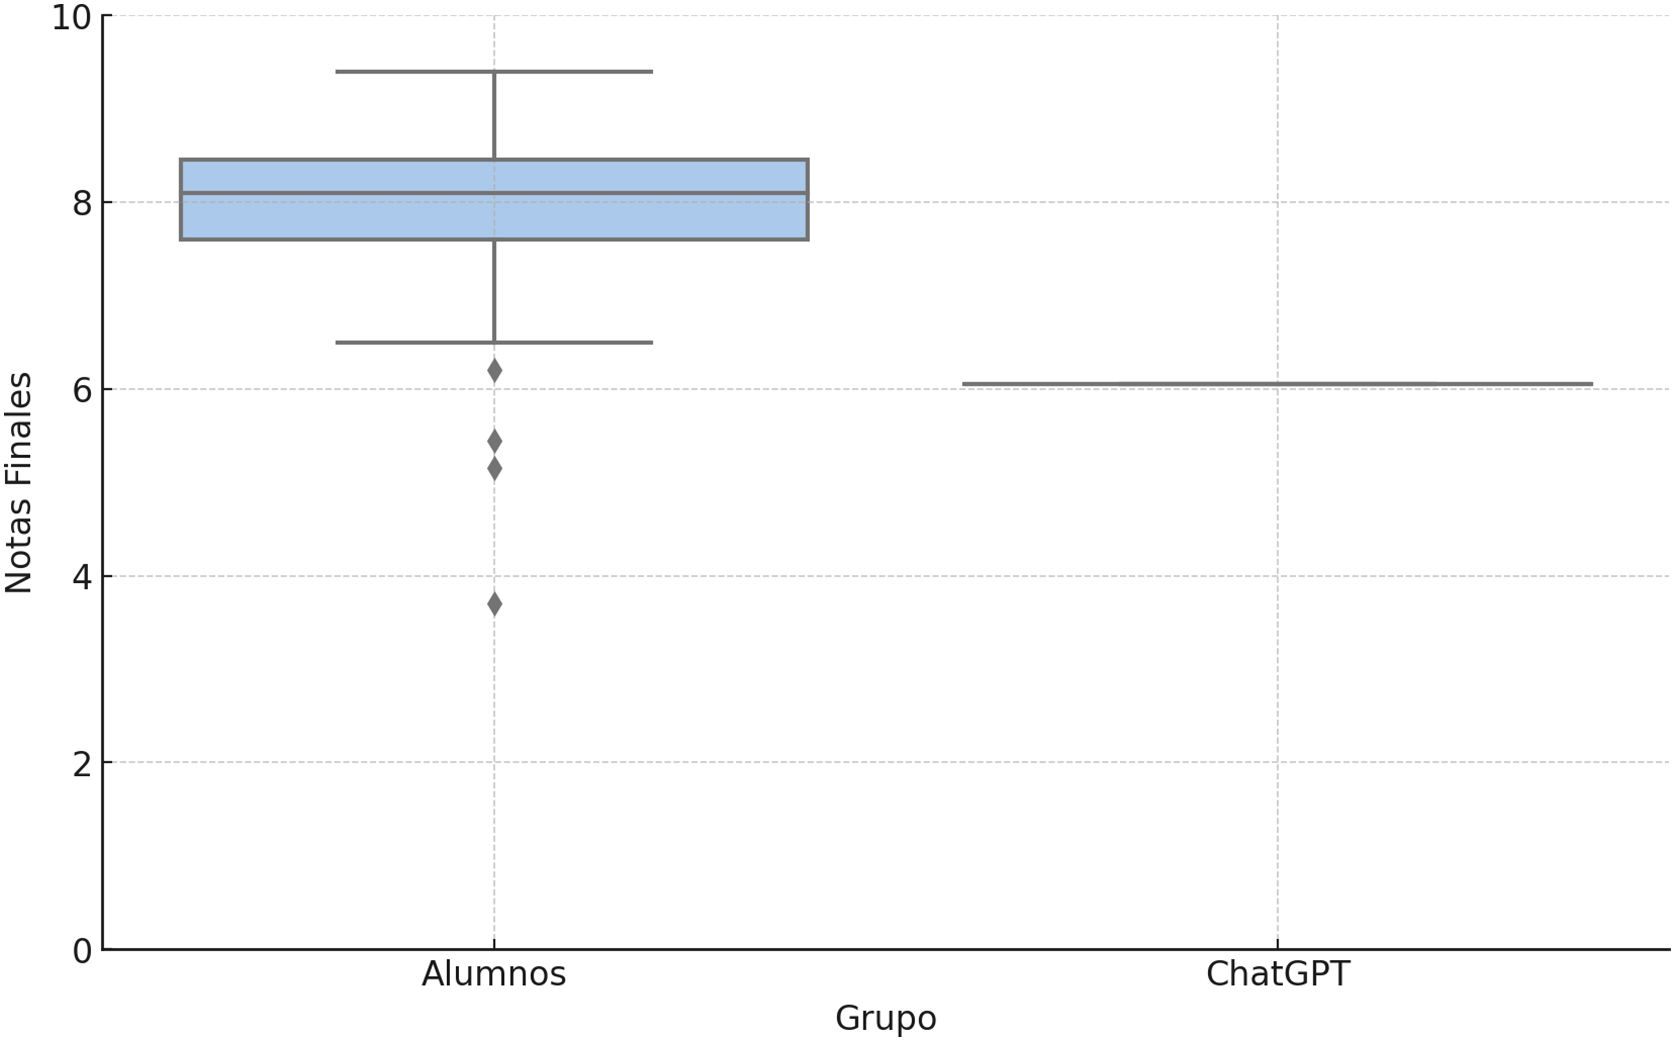
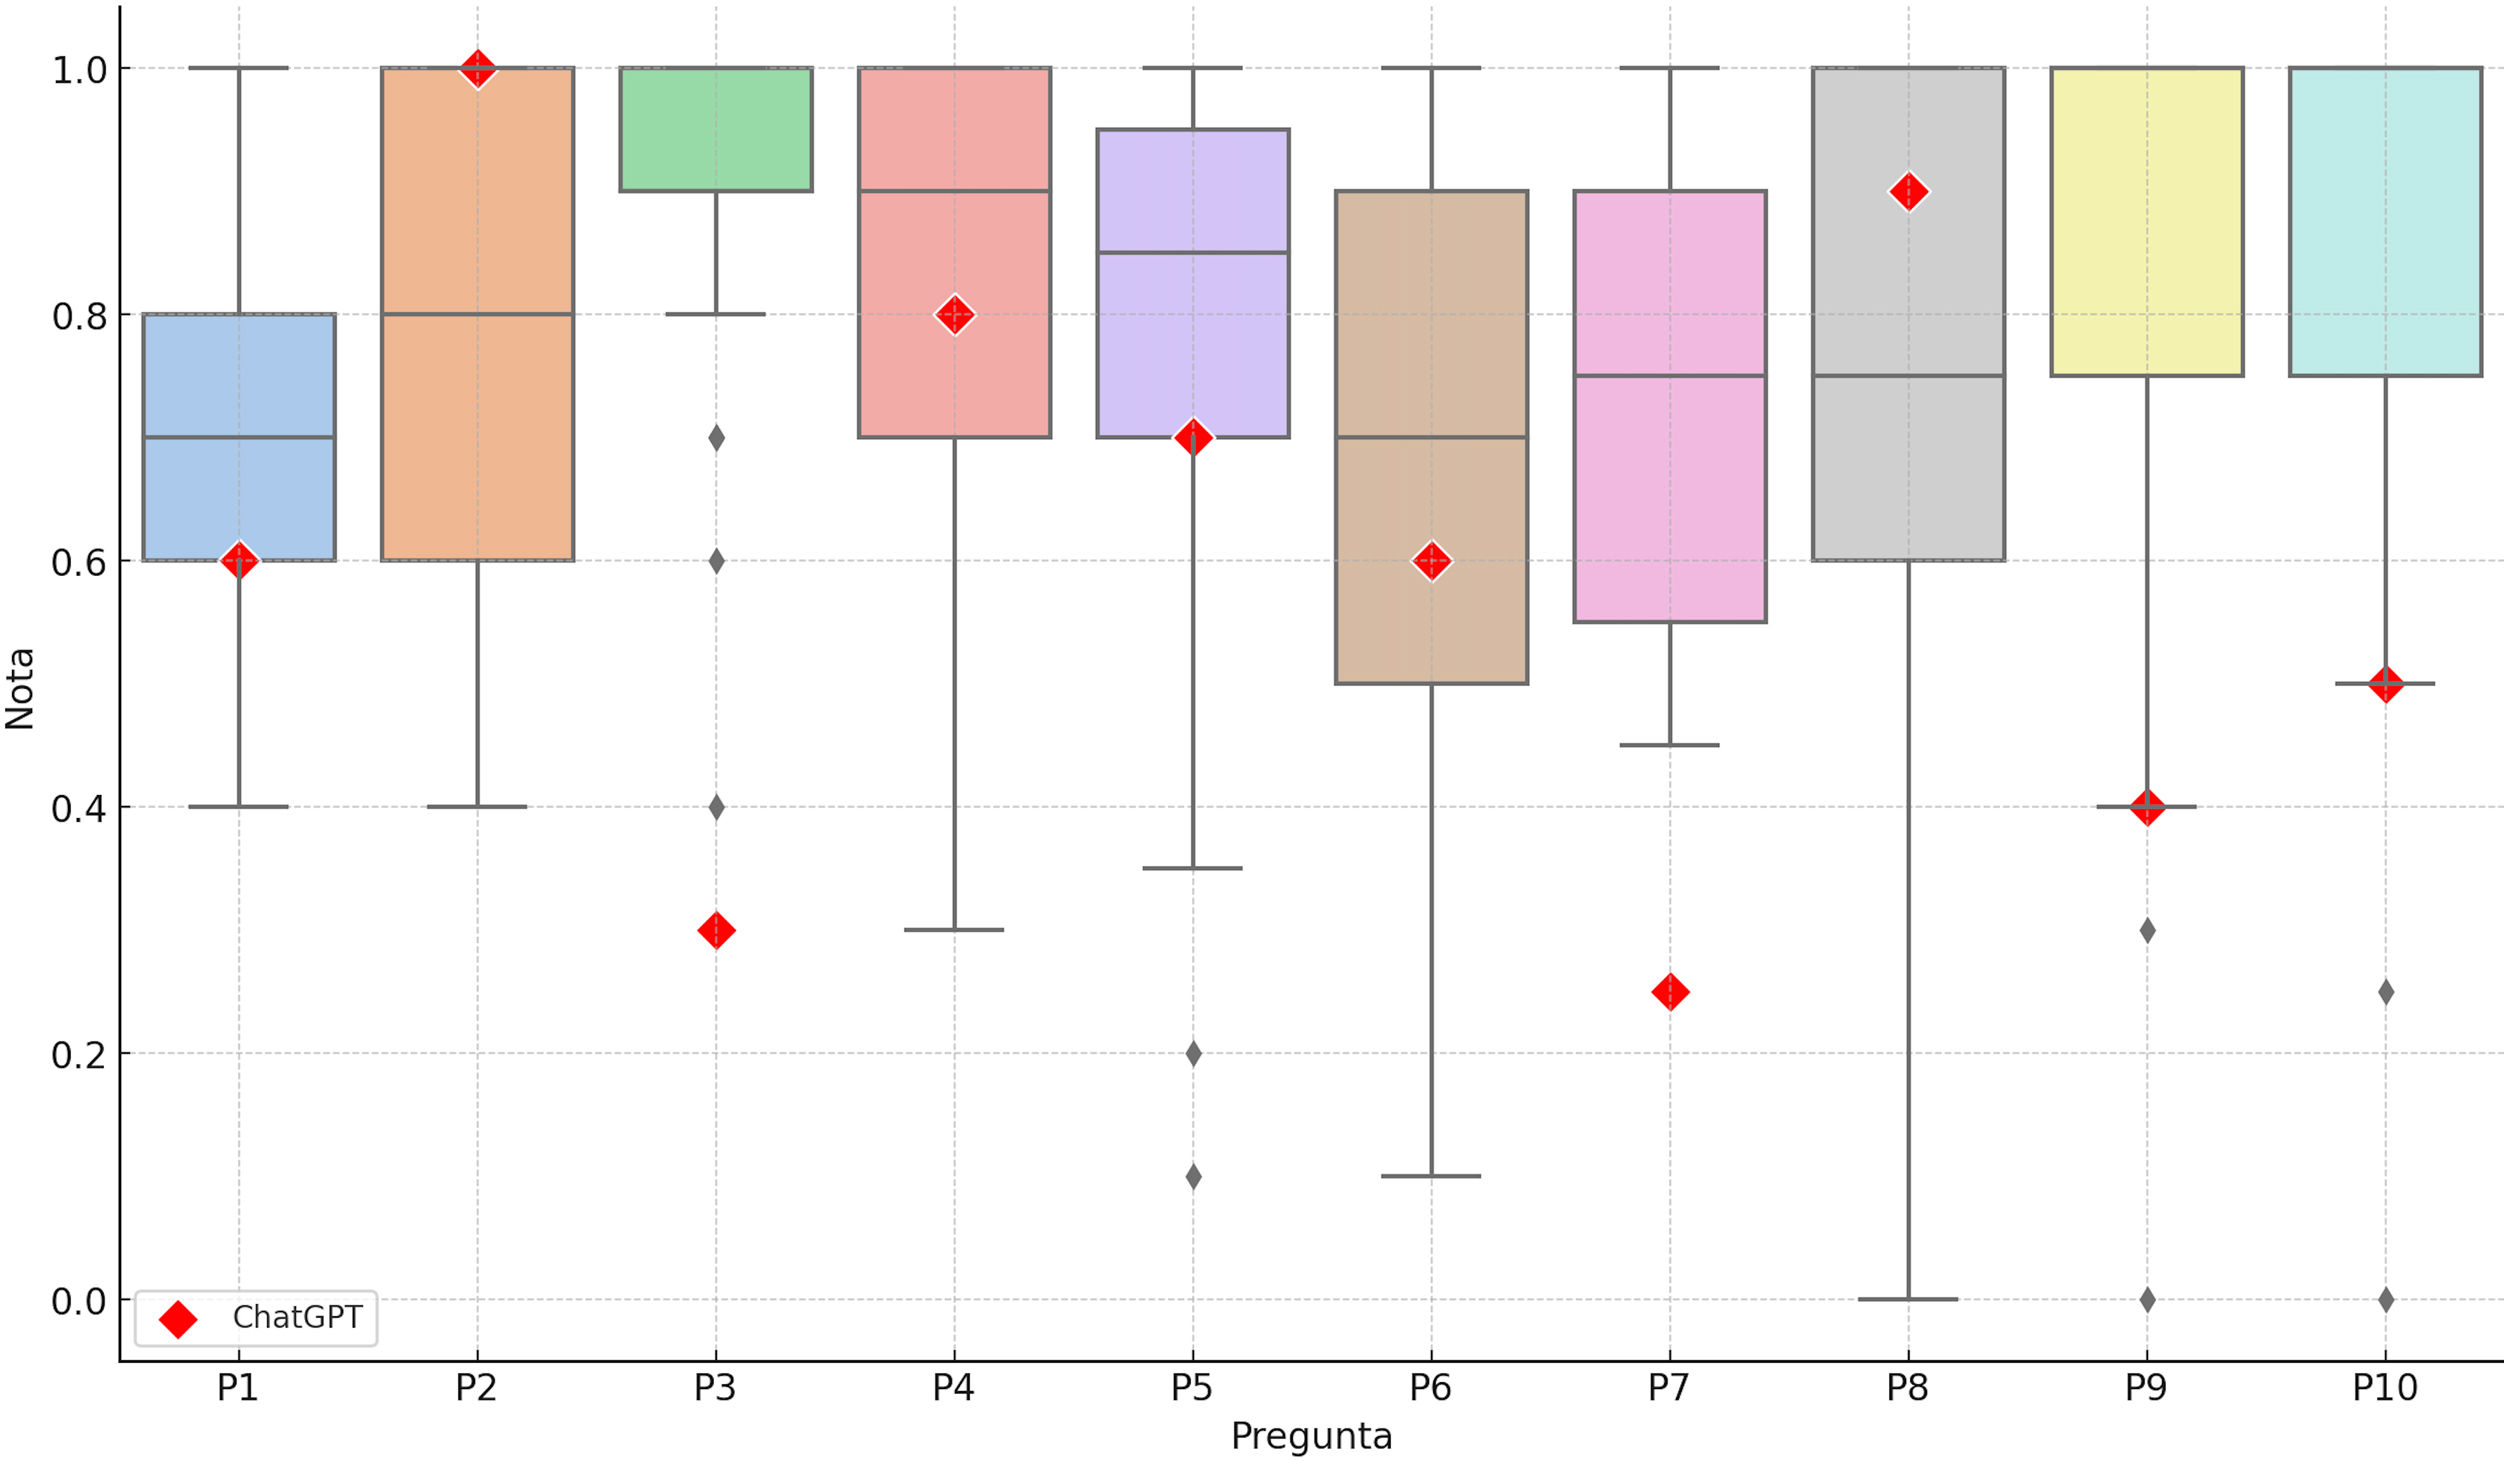
ResultadosLos resultados se presentan en la tabla 1 y gráficamente en las figuras 1 y 2 con cajas de distribución boxplot para las respuestas de los alumnos y el valor de la respuesta del modelo.


Los estudiantes demostraron una mayor capacidad para interpretar imágenes radiológicas complejas, superando a ChatGPT en la mayoría de las preguntas relacionadas con esta área.
Los resultados muestran diferencias estadísticamente significativas tanto en la nota final como en la mayoría de las preguntas (fig. 3), exceptuando las preguntas 1 y 5.

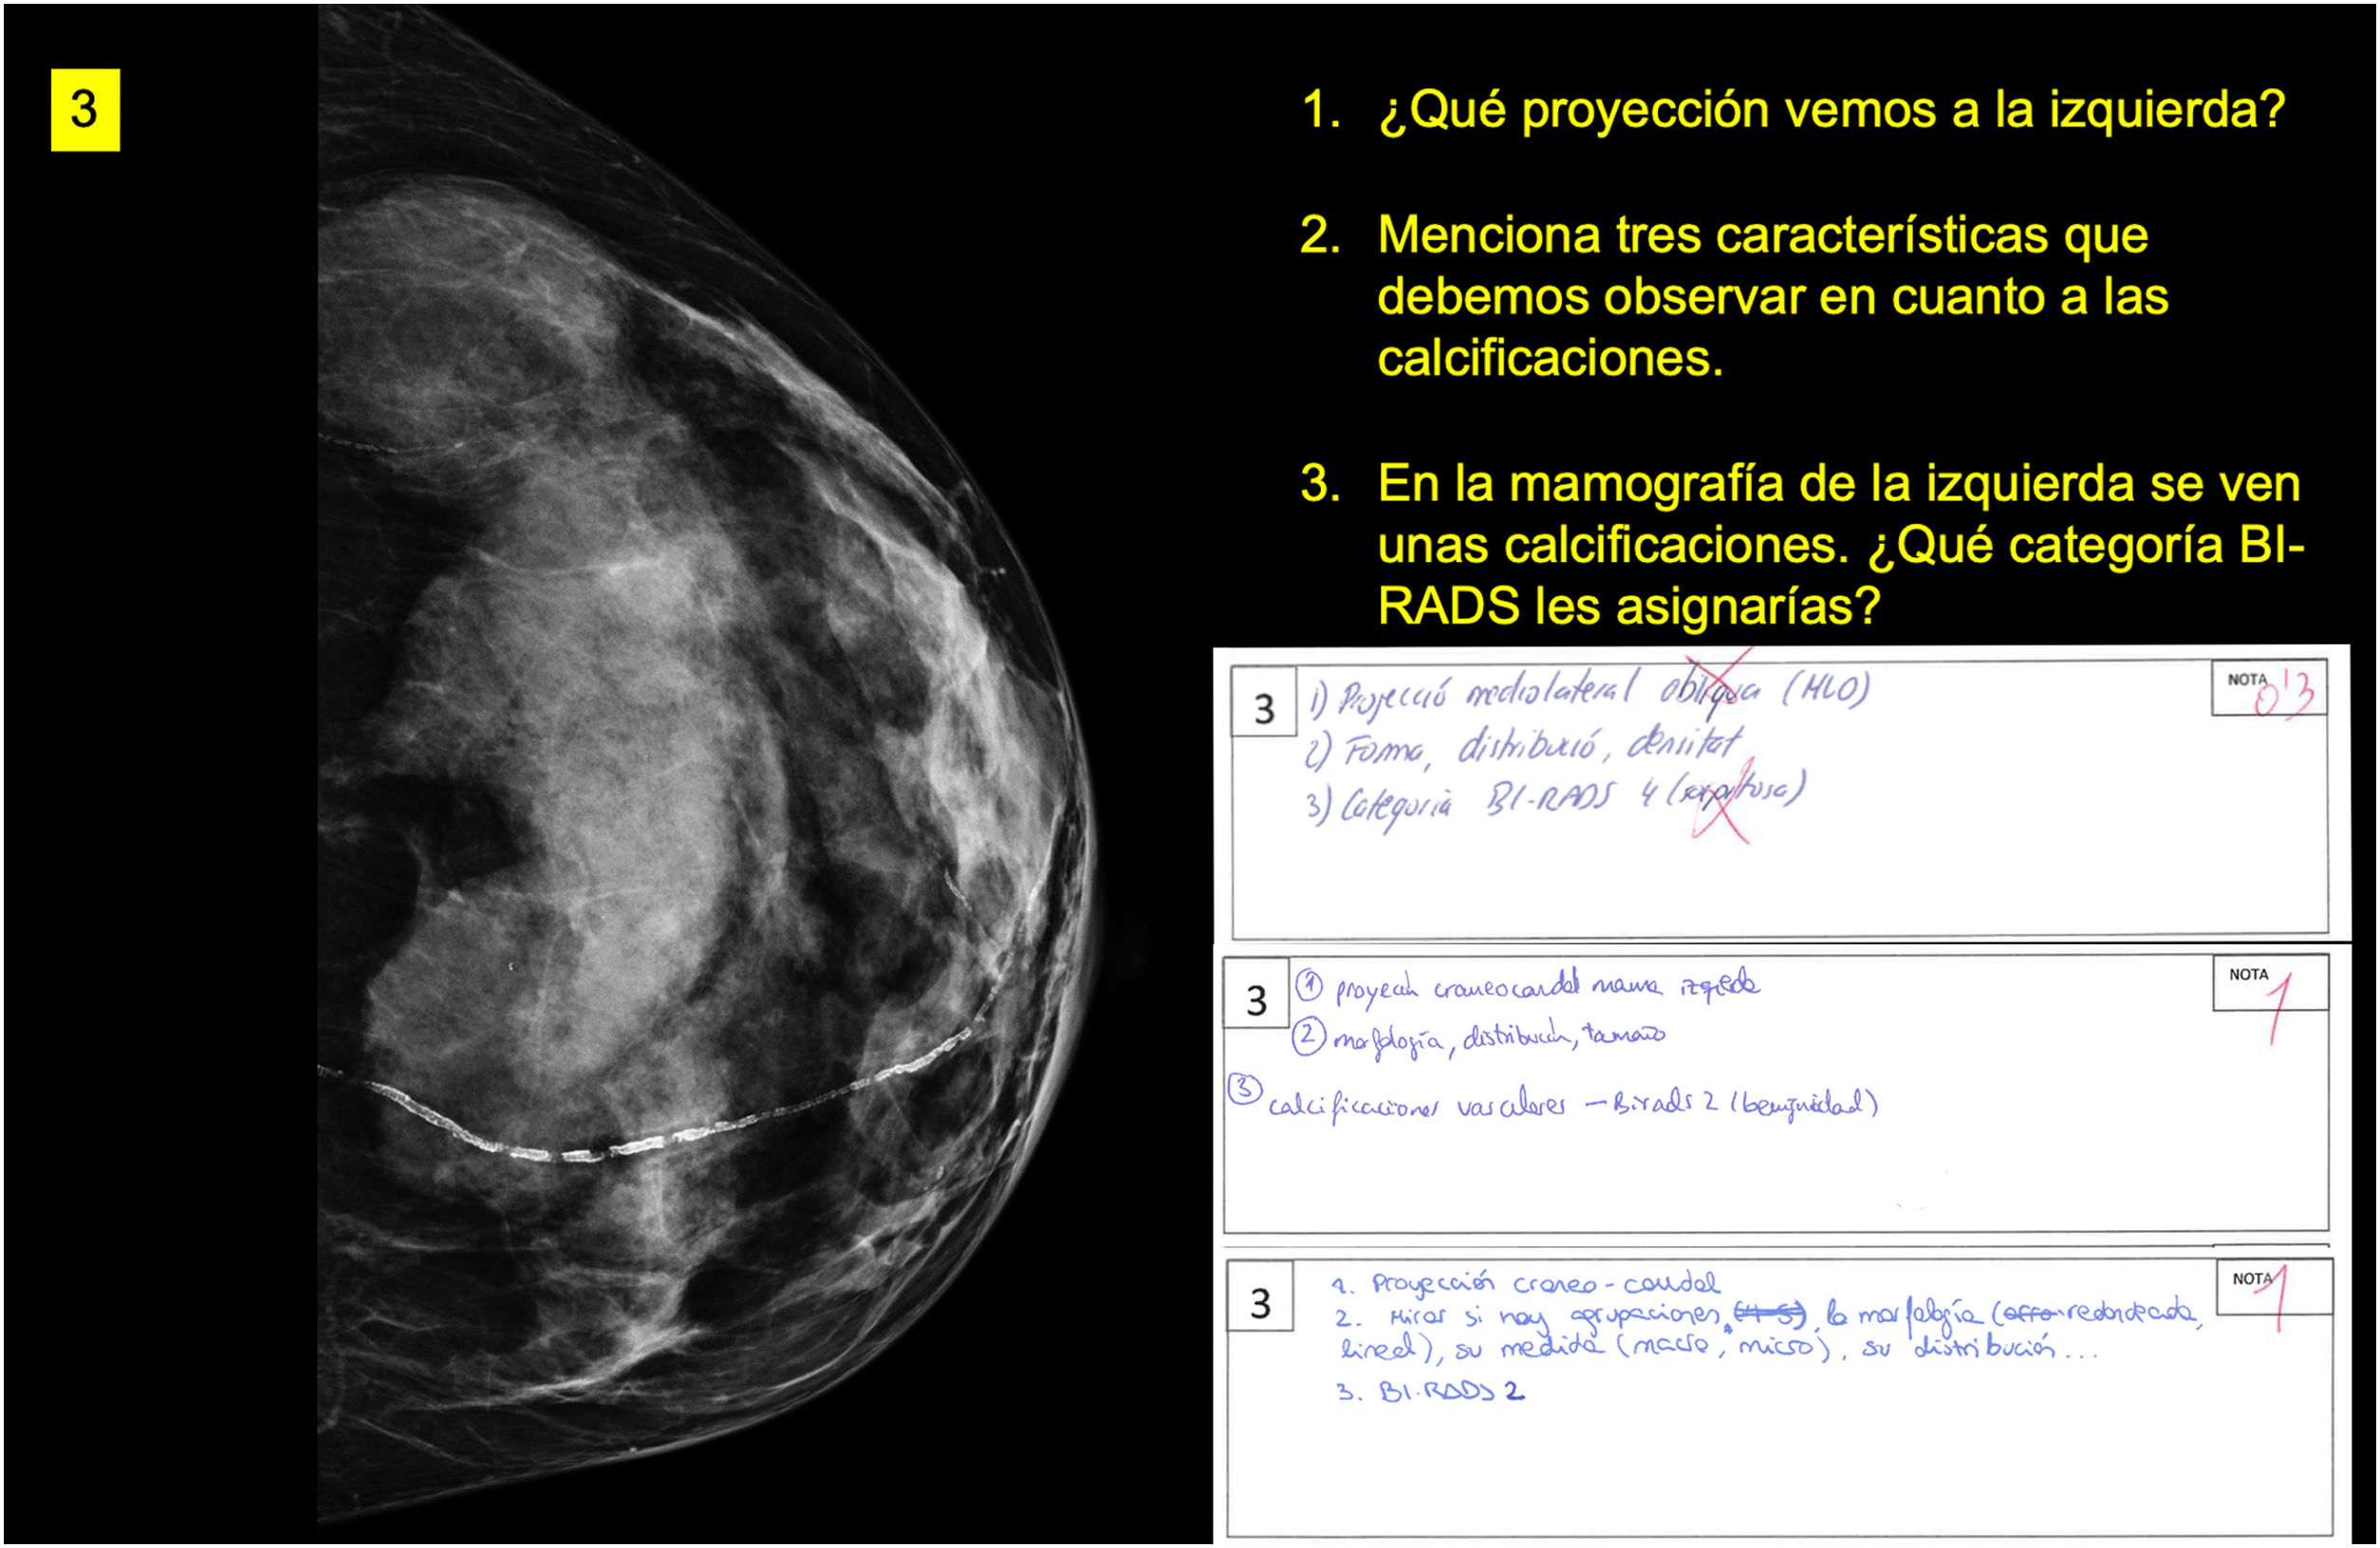
Ejemplo de pregunta y respuestas. Corresponde a la pregunta 3, una imagen de mamografía craneocaudal con calcificaciones vasculares benignas BI-RADS 2. El modelo, la primera de las 3 respuestas mostradas, erró la identificación de la proyección, así como la interpretación de las calcificaciones, a las que concedió un BI-RADS 4, y fue valorada con 0,3 puntos de un máximo de 1 punto. Las otras 2 respuestas mostradas, de alumnos, obtuvieron la nota máxima de 1.
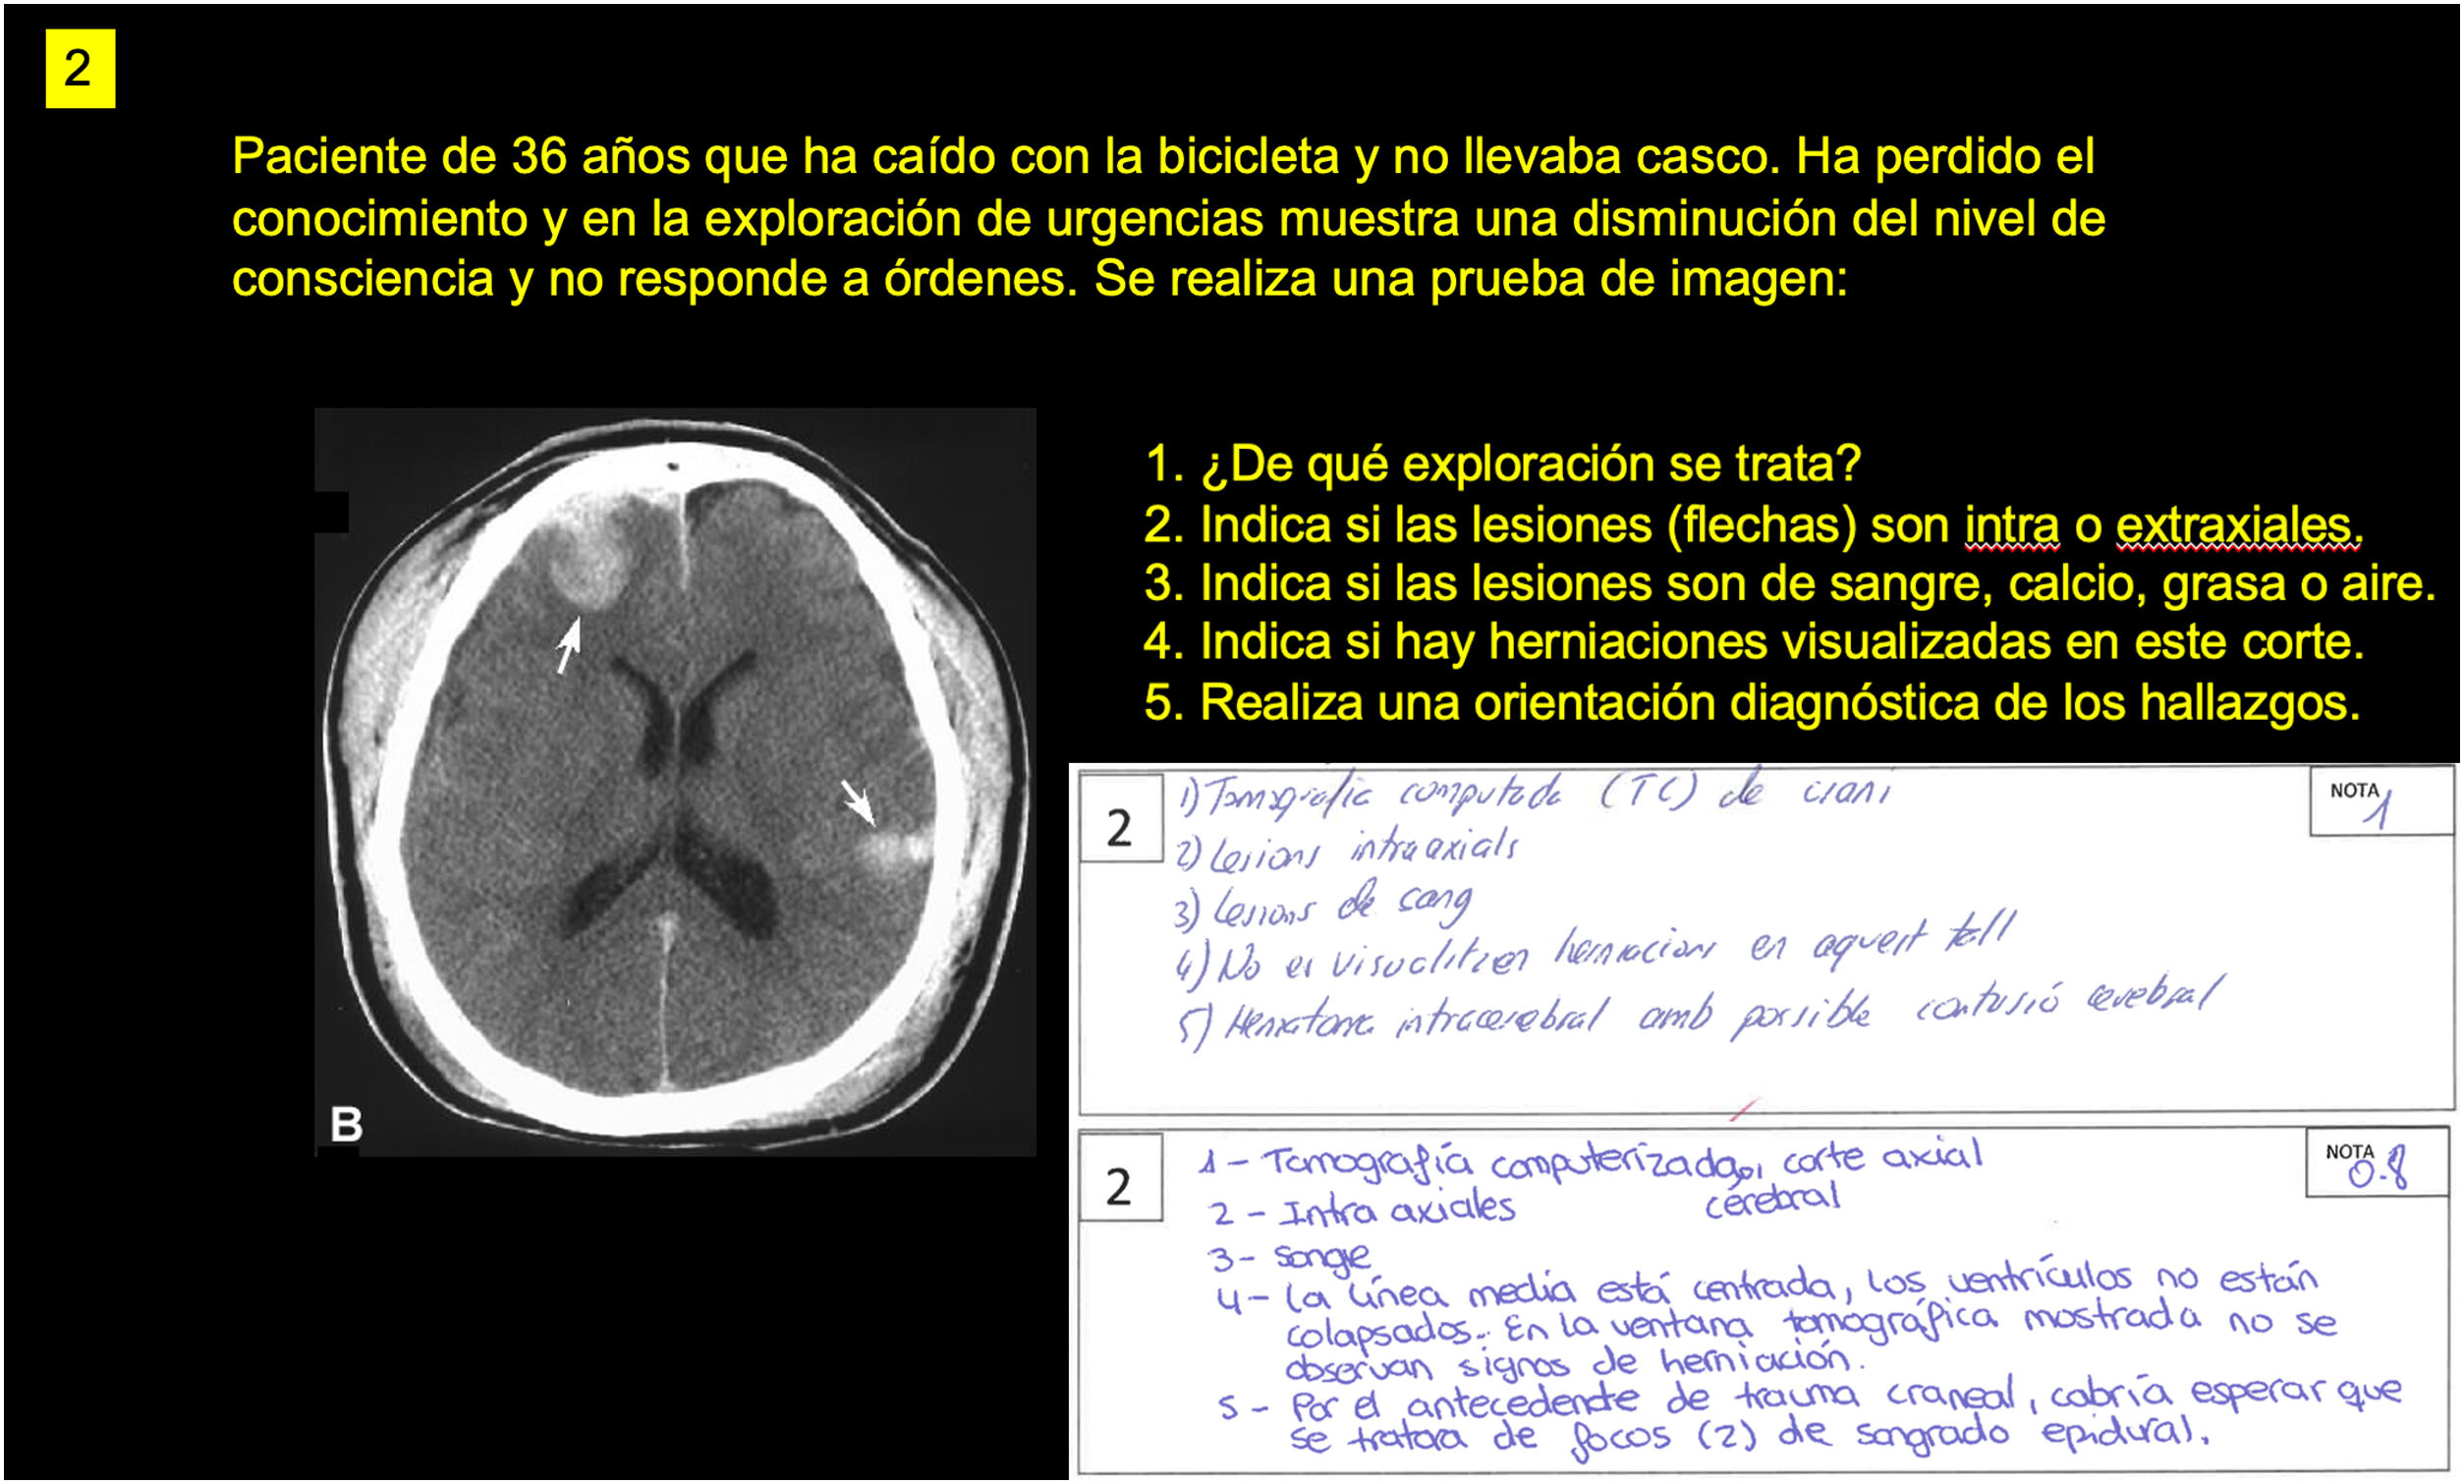
El modelo GPT-4o superó a los alumnos solamente en 2 preguntas: en la pregunta 2, de un sangrado extraaxial en una TC craneal donde obtuvo la máxima calificación (fig. 4), y en la pregunta 8, sobre la identificación e interpretación de una gammagrafía de ventilación-perfusión.

Ejemplo de pregunta y respuestas. La pregunta 2 presentaba una paciente de 36 años con traumatismo craneoencefálico por caída en bici sin casco y afectación neurológica. El modelo (primera respuesta) obtuvo la nota máxima al responder correctamente a todo lo solicitado. La segunda respuesta, de un alumno, erraba el tipo de sangrado en la última de las 5 preguntas, obteniendo 0,8 puntos por la suma de las otras 4 repuestas correctas.
Aunque la nota final del modelo le permitiría aprobar, solo superó la nota de 3 alumnos, situándose en el percentil 9 de la distribución de las notas de los alumnos.
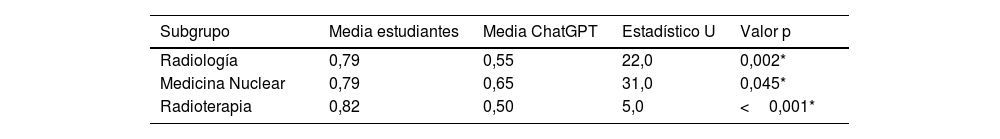
Por áreas de conocimiento, la comparación se muestra en la tabla 2.
Las valoraciones obtenidas en todas las áreas por ChatGTP son inferiores a las de los alumnos y alcanza significación estadística. Las mayores diferencias se obtienen en radiología y en radioterapia.
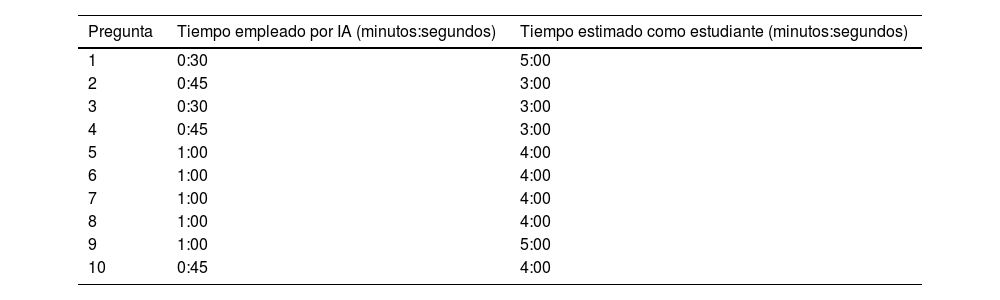
En cuanto al tiempo empleado por ChatGPT para responder a las preguntas, su estimación como un estudiante de Medicina y el tiempo empleado en el análisis y respuesta a cada pregunta, se presentan en la tabla 3.
Tiempo empleado en responder por la IA y el que estima la IA que tardaría un estudiante para cada pregunta
| Pregunta | Tiempo empleado por IA (minutos:segundos) | Tiempo estimado como estudiante (minutos:segundos) |
|---|---|---|
| 1 | 0:30 | 5:00 |
| 2 | 0:45 | 3:00 |
| 3 | 0:30 | 3:00 |
| 4 | 0:45 | 3:00 |
| 5 | 1:00 | 4:00 |
| 6 | 1:00 | 4:00 |
| 7 | 1:00 | 4:00 |
| 8 | 1:00 | 4:00 |
| 9 | 1:00 | 5:00 |
| 10 | 0:45 | 4:00 |
Los alumnos disponían de 5min para responder cada pregunta y no dejaron ninguna respuesta en blanco o incompleta, pero no se evaluó el tiempo empleado por cada estudiante en la respuesta de cada pregunta.
DiscusiónLos resultados indican que ChatGPT tiene un rendimiento aceptable en la interpretación de imágenes para dar respuestas sobre radiología y medicina nuclear, que permitiría obtener un aprobado. Aunque mostró un buen rendimiento en algunas preguntas, especialmente aquellas que requerían información técnica precisa, su capacidad para interpretar imágenes y contextualizar las respuestas en un marco clínico fue limitada e inferior en comparación con los estudiantes. ChatGPT, aunque muestra una capacidad razonable para interpretar imágenes en función de la información textual disponible, carece de la experiencia y el contexto clínico necesarios para igualar el nivel de los estudiantes en esta área. Esto pone de relieve una limitación importante de los modelos de IA: la falta de experiencia práctica y la capacidad limitada para contextualizar información en entornos clínicos complejos.
Cada nueva versión o iteración de este modelo de IA generativa ofrece un rendimiento mejorado debido a un aprendizaje más profundo y específico. En particular en el campo de la educación médica, la versión GPT-4 ofrecía un rendimiento del 94%, que es marcadamente superior a su versión previa, que obtenía un 66% de respuestas correctas a preguntas MIR de la asignatura de Reumatología7.
La interpretación de preguntas de radiología o medicina nuclear que puedan incluir imágenes médicas, sin embargo, va más allá del análisis de una situación clínica a partir de datos de texto y valores de pruebas de laboratorio, lo que supone un nivel superior de interpretación de datos y contextualización clínica. De hecho, el rendimiento de ChatGPT en preguntas sin imágenes de examen de radiología tipo Board de los Estados Unidos de América era alto para preguntas sencillas (84% de aciertos), pero moderado en las que requería describir hallazgos (60%) y bajo para calcular y clasificar (25%) o en la aplicación de conceptos radiológicos (30%)15. El modelo anterior, GPT-4V, que puede interpretar imágenes, también presenta limitaciones en la capacidad de interpretar hallazgos patológicos en placas simples de tórax16.
GPT-4o, en su última versión, que es la utilizada en este estudio, ha sido entrenado con una enorme cantidad de datos textuales y visuales, que incluyen datos provenientes de libros, artículos, sitios web y otras fuentes públicas y licenciadas. Se estima que los datos utilizados abarcan varios petabits (1.024 terabits) de información, lo que representa un aumento significativo en comparación con versiones anteriores como GPT-3 y GPT-4. Aunque no se han divulgado cifras exactas sobre la cantidad de imágenes radiológicas utilizadas, la escala de datos empleados es considerable. Se sabe que GPT-4o ha analizado de manera extensa imágenes médicas, incluyendo radiografías, TC, RM y otras modalidades de imagen médica para mejorar su capacidad de análisis y diagnóstico en contextos clínicos. Según explica el propio modelo, durante el entrenamiento de GPT-4o, se ha hecho especial énfasis en mejorar la capacidad del modelo para interpretar y generar respuestas precisas a partir de imágenes médicas complejas. Esto incluye tareas como la generación de informes radiológicos, la respuesta a preguntas visuales médicas y la identificación de características anatómicas y patológicas en imágenes médicas17.
Sin embargo, al analizar nuestros resultados observamos que el modelo equivocó la lateralidad del hallazgo más relevante en 2 de las preguntas. De los errores que cometió en nuestro estudio destacan: la no identificación de calcificaciones vasculares ni el tipo de proyección en una imagen de mamografía, la interpretación incorrecta del lado de una lesión torácica en una radiografía o de una masa vesical con ureterohidronefrosis en una imagen ecográfica y de TC, y por último, la confusión de una imagen axial hepática de RM potenciada en T2 por una de T1 con contraste, y la confusión en la identificación en la misma de los grandes vasos. Errores que, habiendo recibido la valoración tras la corrección, probablemente se subsanarán en una futura versión.
En un análisis de los artículos que han evaluado el rendimiento de ChatGPT en radiología, el 84% reportan un alto rendimiento con una precisión media del 70%, y cuando los estudios comparan la precisión entre la versión 3.5 y la 4, se identificó una importante mejora entre versiones en la comprensión de términos radiológicos y en la descripción de los hallazgos18.
La utilidad para el autoaprendizaje con ChatGPT como asistente para la resolución de dudas, para generar preguntas para preparar un examen o para obtener respuestas razonadas a preguntas anteriores hace que muchos estudiantes utilicen estos modelos cada vez con mayor asiduidad para mejorar su aprendizaje y obtener mejores resultados. Por otro lado, nuestro estudio revela que la IA estima que un estudiante podría responder dentro del tiempo establecido todas las preguntas, lo que permitiría a los profesores valorar a priori si sus preguntas pueden ser respondidas por los estudiantes en el tiempo límite establecido.
Las limitaciones del estudio incluyen que la muestra de estudiantes fue relativamente pequeña y no necesariamente representativa de la población estudiantil general, que 2 de los 10 evaluadores no estaban ciegos al estudio y que el análisis se ha hecho sobre 10 preguntas muy parceladas que podrían no ser representativas de toda la asignatura, lo que podría limitar la generalización de los resultados. Por otro lado, es de notar que el modelo de IA carecía de entrenamiento específico y que, en cambio, las preguntas fueron realizadas por los mismos profesores que imparten las prácticas y habían formado y entrenado a los alumnos.
Es innegable el potencial que tienen los modelos de IA generativa. Actualmente, en la interpretación de imágenes radiológicas y la contextualización clínica, los estudiantes de Medicina tienen una ventaja significativa sobre GPT-4. Sin embargo, debido a que GPT-4 es una herramienta nueva, su uso se está expandiendo rápidamente y su capacidad de mejora es continua y a gran velocidad. Esto apunta a que será útil como herramienta complementaria tanto para el aprendizaje de los estudiantes de Medicina y residentes de radiología como para la práctica profesional de los radiólogos.
ConclusionesChatGPT representa una herramienta prometedora como soporte en la interpretación de imágenes médicas, aunque aún no puede equipararse a la habilidad humana en situaciones clínicas complejas. La continua evolución y mejora de modelos como ChatGPT tienen gran potencial como herramienta de apoyo en la práctica clínica y educativa.
Autoría- 1.
Responsable de la integridad del estudio: RS.
- 2.
Concepción del estudio: RS, XS, LO, CN.
- 3.
Diseño del estudio: RS, XS, LO, CN.
- 4.
Obtención de los datos: RS, XS, LO, CN.
- 5.
Análisis e interpretación de los datos: RS, XS, LO, CN.
- 6.
Tratamiento estadístico: RS.
- 7.
Búsqueda bibliográfica: RS, MMG.
- 8.
Redacción del trabajo: RS, LO, CN.
- 9.
Revisión crítica del manuscrito con aportaciones intelectualmente relevantes: RS, DV, LO, MMG, ACF, XS, CN.
- 10.
Aprobación de la versión final: RS, DV, LO, MMG, ACF, XS, CN.
Durante la preparación de este trabajo los autores utilizaron GPT-4o como objeto de estudio y para el análisis estadístico. Tras utilizar dicha herramienta, los autores revisaron y editaron el contenido según necesidad, asumiendo la plena responsabilidad del contenido de la publicación.
FinanciaciónLa presente investigación no ha recibido ayudas específicas provenientes de agencias del sector público, sector comercial o entidades sin ánimo de lucro.
Los autores declaran no tener ningún conflicto de interés.