

El razonamiento clínico (RC) y el diagnóstico diferencial (DD) son competencias nucleares de la medicina. Los modelos de lenguaje de gran tamaño (LLM) han despertado un marcado interés como herramientas de apoyo al diagnóstico.
Este artículo revisa narrativamente la evidencia disponible, organizada en torno a cinco preguntas clave: el efecto de los LLM sobre el DD y la calidad del proceso de razonamiento, la optimización de la interacción clínico-LLM, el momento adecuado de consulta, los modelos de integración más seguros y los principales riesgos asociados.
La evidencia muestra que los LLM mejoran el DD cuando los emplean profesionales entrenados dentro de flujos estructurados. Sin embargo, el uso pasivo genera sesgos, y la colaboración médico-IA no supera de forma consistente al LLM autónomo.
Se propone un marco práctico según el grado de incertidumbre diagnóstica, con recomendaciones orientadas a modelos de «médico en el bucle», donde los LLM amplifican, tensionan y hacen explícito el RC bajo supervisión humana crítica.
Clinical reasoning and differential diagnosis are core competencies in medicine. Large language models (LLMs) have generated considerable interest as potential tools to support these skills.
This article presents a narrative review of the available evidence, organized around five key questions: the effect of LLMs on diagnostic reasoning, the optimal design of clinician-LLM interaction, the appropriate timing of consultation during the clinical encounter, the safest models of clinical-AI integration, and the main risks associated with their use.
The evidence shows that LLMs improve differential diagnosis when used by trained professionals within structured workflows. However, passive use generates biases, and clinician-AI collaboration may not consistently outperform autonomous LLMs.
A practical framework stratified by degree of diagnostic uncertainty is proposed, with operational and educational recommendations oriented toward “physician-in-the-loop” models, in which LLMs amplify, challenge, and make explicit the diagnostic reasoning process under critical human oversight.
El razonamiento clínico (RC) es una habilidad esencial de la práctica médica. Permite reunir, analizar e integrar datos del paciente para orientar el diagnóstico, el pronóstico y el tratamiento1. El diagnóstico diferencial (DD) es central en este proceso, al exigir recuperar conocimientos previos para generar, organizar y priorizar las posibles enfermedades2. Elaborar un DD exige evaluar críticamente la evidencia, reconocer lagunas de información y contextualizar los hallazgos en la realidad clínica y emocional del paciente3. Para alcanzar dichos objetivos, los médicos se apoyan en atributos aparentemente insustituibles por la tecnología como la comunicación clínica, la experiencia acumulada y la empatía con el paciente4.
La reciente aparición de la inteligencia artificial (IA) generativa y los modelos de lenguaje de gran tamaño (LLM) ha despertado un notable interés como apoyo al RC. Estas herramientas pueden contribuir a ampliar el abanico del DD5, actuar como segunda opinión6 y ofrecer apoyo adicional en casos complejos, infrecuentes7,8 o atendidos por clínicos con menor experiencia9. Sin embargo, su utilidad no depende solo de su disponibilidad y de su capacidad técnica, sino de cómo se integren en la práctica clínica.
El uso inadecuado de los LLM puede comprometer la seguridad del paciente. Estos modelos pueden ofrecer respuestas discordantes ante preguntas idénticas (por variabilidad en su generación de texto, sensibilidad al formato de la instrucción o actualizaciones del modelo)10, generar errores plausibles o alucinaciones11 y reproducir sesgos o problemas de equidad12,13. Su empleo acrítico puede deteriorar habilidades, dificultar nuevas competencias y consolidar hábitos clínicos erróneos si se aceptan sus respuestas sin revisión14. Esta aceptación pasiva puede generar una «deuda cognitiva», un riesgo aún emergente vinculado a los fenómenos de deskilling o pérdida de habilidades15 y sesgo de automatización16 descritos en la literatura, al aumentar la dependencia tecnológica y la vulnerabilidad del profesional cuando el modelo se equivoca14.
La rápida evolución de la IA supera la capacidad de muchos clínicos para incorporarla de forma segura y responsable. Por ello, es necesario revisar críticamente la evidencia y convertirla en recomendaciones operativas para la práctica clínica y la educación médica. Este artículo sintetiza narrativamente la evidencia publicada en torno a varias preguntas clave y propone, desde el consenso de los autores, un marco práctico para su uso e integración formativa.
En el material suplementario (tabla 1) se exponen la terminología y las definiciones utilizadas en el artículo.
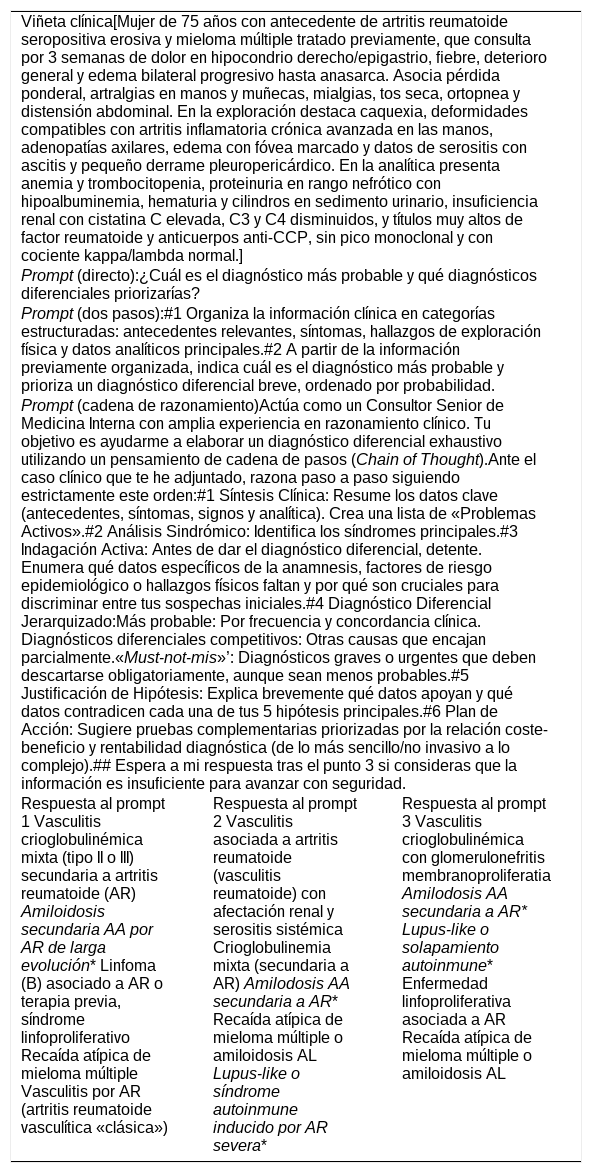
Ejemplos de instrucciones (prompts) para solicitar un diagnóstico diferencial en base a un ejemplo
| Viñeta clínica[Mujer de 75 años con antecedente de artritis reumatoide seropositiva erosiva y mieloma múltiple tratado previamente, que consulta por 3 semanas de dolor en hipocondrio derecho/epigastrio, fiebre, deterioro general y edema bilateral progresivo hasta anasarca. Asocia pérdida ponderal, artralgias en manos y muñecas, mialgias, tos seca, ortopnea y distensión abdominal. En la exploración destaca caquexia, deformidades compatibles con artritis inflamatoria crónica avanzada en las manos, adenopatías axilares, edema con fóvea marcado y datos de serositis con ascitis y pequeño derrame pleuropericárdico. En la analítica presenta anemia y trombocitopenia, proteinuria en rango nefrótico con hipoalbuminemia, hematuria y cilindros en sedimento urinario, insuficiencia renal con cistatina C elevada, C3 y C4 disminuidos, y títulos muy altos de factor reumatoide y anticuerpos anti-CCP, sin pico monoclonal y con cociente kappa/lambda normal.] | ||
| Prompt (directo):¿Cuál es el diagnóstico más probable y qué diagnósticos diferenciales priorizarías? | ||
| Prompt (dos pasos):#1 Organiza la información clínica en categorías estructuradas: antecedentes relevantes, síntomas, hallazgos de exploración física y datos analíticos principales.#2 A partir de la información previamente organizada, indica cuál es el diagnóstico más probable y prioriza un diagnóstico diferencial breve, ordenado por probabilidad. | ||
| Prompt (cadena de razonamiento)Actúa como un Consultor Senior de Medicina Interna con amplia experiencia en razonamiento clínico. Tu objetivo es ayudarme a elaborar un diagnóstico diferencial exhaustivo utilizando un pensamiento de cadena de pasos (Chain of Thought).Ante el caso clínico que te he adjuntado, razona paso a paso siguiendo estrictamente este orden:#1 Síntesis Clínica: Resume los datos clave (antecedentes, síntomas, signos y analítica). Crea una lista de «Problemas Activos».#2 Análisis Sindrómico: Identifica los síndromes principales.#3 Indagación Activa: Antes de dar el diagnóstico diferencial, detente. Enumera qué datos específicos de la anamnesis, factores de riesgo epidemiológico o hallazgos físicos faltan y por qué son cruciales para discriminar entre tus sospechas iniciales.#4 Diagnóstico Diferencial Jerarquizado:Más probable: Por frecuencia y concordancia clínica.Diagnósticos diferenciales competitivos: Otras causas que encajan parcialmente.«Must-not-mis»’: Diagnósticos graves o urgentes que deben descartarse obligatoriamente, aunque sean menos probables.#5 Justificación de Hipótesis: Explica brevemente qué datos apoyan y qué datos contradicen cada una de tus 5 hipótesis principales.#6 Plan de Acción: Sugiere pruebas complementarias priorizadas por la relación coste-beneficio y rentabilidad diagnóstica (de lo más sencillo/no invasivo a lo complejo).## Espera a mi respuesta tras el punto 3 si consideras que la información es insuficiente para avanzar con seguridad. | ||
| Respuesta al prompt 1 Vasculitis crioglobulinémica mixta (tipo II o III) secundaria a artritis reumatoide (AR) Amiloidosis secundaria AA por AR de larga evolución* Linfoma (B) asociado a AR o terapia previa, síndrome linfoproliferativo Recaída atípica de mieloma múltiple Vasculitis por AR (artritis reumatoide vasculítica «clásica») | Respuesta al prompt 2 Vasculitis asociada a artritis reumatoide (vasculitis reumatoide) con afectación renal y serositis sistémica Crioglobulinemia mixta (secundaria a AR) Amilodosis AA secundaria a AR* Recaída atípica de mieloma múltiple o amiloidosis AL Lupus-like o síndrome autoinmune inducido por AR severa* | Respuesta al prompt 3 Vasculitis crioglobulinémica con glomerulonefritis membranoproliferatia Amilodosis AA secundaria a AR* Lupus-like o solapamiento autoinmune* Enfermedad linfoproliferativa asociada a AR Recaída atípica de mieloma múltiple o amiloidosis AL |
Diagnóstico del caso.
Respuestas obtenidas utilizando como LLM Microsoft Copilot, versión integrada en el paquete Microsoft 365, accesible en el entorno del Sistema de Salud de Castilla y León (SACYL) durante el periodo de elaboración del manuscrito (marzo 2026) a partir de la información inicial disponible en Jonas et al.22.
La evidencia disponible es mixta. Los LLM superan de forma consistente al médico cuando se comparan de forma independiente, pero su efecto cuando médico y LLM colaboran es más incierto y depende de cómo se integran en la práctica. Los LLM pueden mejorar el DD si se utilizan con una estrategia definida, dentro de flujos de trabajo estructurados y por profesionales que conocen tanto sus capacidades como sus limitaciones5.
Tres ensayos clínicos con resultados aparentemente opuestos ilustran esta idea. En el primero, realizado con 50 médicos, el acceso a la IA junto con recursos convencionales no mejoró de forma significativa el DD frente al uso exclusivo de recursos convencionales (Características del modelo de LLM utilizado y tipo de profesionales incluidos en el estudio [CMTP]: modelo GPT-4, ChatGPT plus, aplicado con médicos de familia, emergencias y medicina interna)17. La diferencia fue de solo+2 puntos porcentuales (IC 95%: −4 a+8; p=0,60). Sin embargo, el LLM evaluado en solitario superó a ambos grupos de médicos. Este hallazgo sugiere que el problema no era la falta de capacidad del modelo, sino la forma en que los clínicos interactuaron con él. Una posible explicación es que algunos clínicos emplearan el modelo como herramienta de búsqueda para confirmar hipótesis previas, en lugar de ampliar o cuestionar el DD, un patrón compatible con la «paradoja de la colaboración» descrita en otros estudios6.
Un segundo ensayo clínico mostró un patrón complementario (CMTP: Modelo GPT-4o, aplicado con médicos de distintas áreas)18. En este estudio, 60 médicos recibieron formación estructurada de 20 horas en alfabetización en IA (capacidades, limitaciones, prompting [diseño y estructuración de instrucciones], verificación crítica) antes de usar GPT-4o. El grupo con LLM alcanzó 71,4% de DD frente al 42,6% del control (+27,5 puntos, IC 95%: 22,8–32,2; p<0,001), sin aumento significativo del tiempo por caso.
Por último, otro estudio (CMTP: Modelo o1-preview, médicos residentes y adjuntos de medicina interna y urgencias) aporta nueva evidencia de que ya superan a los médicos como referencia en múltiples tareas de RC19.
En conjunto, estos resultados podrían indicar que el efecto de los LLM sobre el DD depende menos del modelo en sí que del modo en que se integra en la práctica, aunque esta interpretación se basa en un número limitado de ensayos, predominantemente con viñetas clínicas simuladas y no con pacientes reales. Cuando el médico recurre al LLM de manera pasiva o confirmatoria, el beneficio es escaso y puede incluso ser contraproducente al reforzar sesgos previos. Cuando existe formación específica y se emplean flujos de trabajo que obligan al profesional a mantener su esfuerzo cognitivo, el LLM puede actuar como un amplificador del razonamiento, ayudando a expandir el DD, revisar supuestos y detectar lagunas.
Por tanto, la pregunta no es si los LLM «razonan» mejor que los médicos, sino en qué condiciones ayudan al médico a razonar mejor. La evidencia sugiere la conveniencia de dos requisitos previos al uso de los LLM: a) la alfabetización específica en IA y b) el uso dentro de estrategias estructuradas de colaboración clínico-LLM. Los modelos con razonamiento explícito muestran ventajas en precisión diagnóstica para casos complejos (mejoran la precisión en los diagnósticos Top-1 y Top-5, pero no en Top-10) (CMTP: 22 LLM, 164 casos clínicos de medicina interna)20, aunque esta ventaja no es universal. En tareas de estimación de probabilidades diagnósticas (p. ej., ajustar la probabilidad de una enfermedad tras el resultado de una prueba), algunos modelos de razonamiento muestran exceso de confianza y no superan a los modelos generalistas de alta calidad. (CMTP: 10 LLM, 750 preguntas de concordancia de guion)21. La elección del modelo, por tanto, depende del tipo de tarea clínica para la que se utilice.
Segunda: la forma de cómo el médico debe estructurar su instrucción en el modelo de lenguaje de gran tamañoEl prompt que el médico da al modelo no es solo cuestión de preferencia personal: condiciona directamente la calidad, amplitud y claridad de la respuesta diagnóstica. La evidencia sugiere que las instrucciones más útiles no piden un diagnóstico libre, sino que obligan al modelo a organizar la información clínica, explicar su razonamiento y revisarlo críticamente.
Para ilustrar de forma práctica esto utilizaremos como ejemplo un caso clínico publicado recientemente en New England Journal of Medicine (una mujer de 75 años con artritis reumatoide de larga evolución que ingresa por cuadro de deterioro, con proteinuria y edema y donde la hipocomplementemia y la serositis son clave para establecer un diagnóstico final de AR, lupus y amiloidosis)22. Los autores utilizaron Copilot de Microsoft (marzo de 2026), al ser el LLM institucional disponible en el centro de trabajo de tres de ellos (servicios de Salud de Castilla y León y Madrid), evaluando el caso clínico con tres estrategias de instrucción, ordenadas de menor a mayor utilidad de estructura el RC (tabla 1).
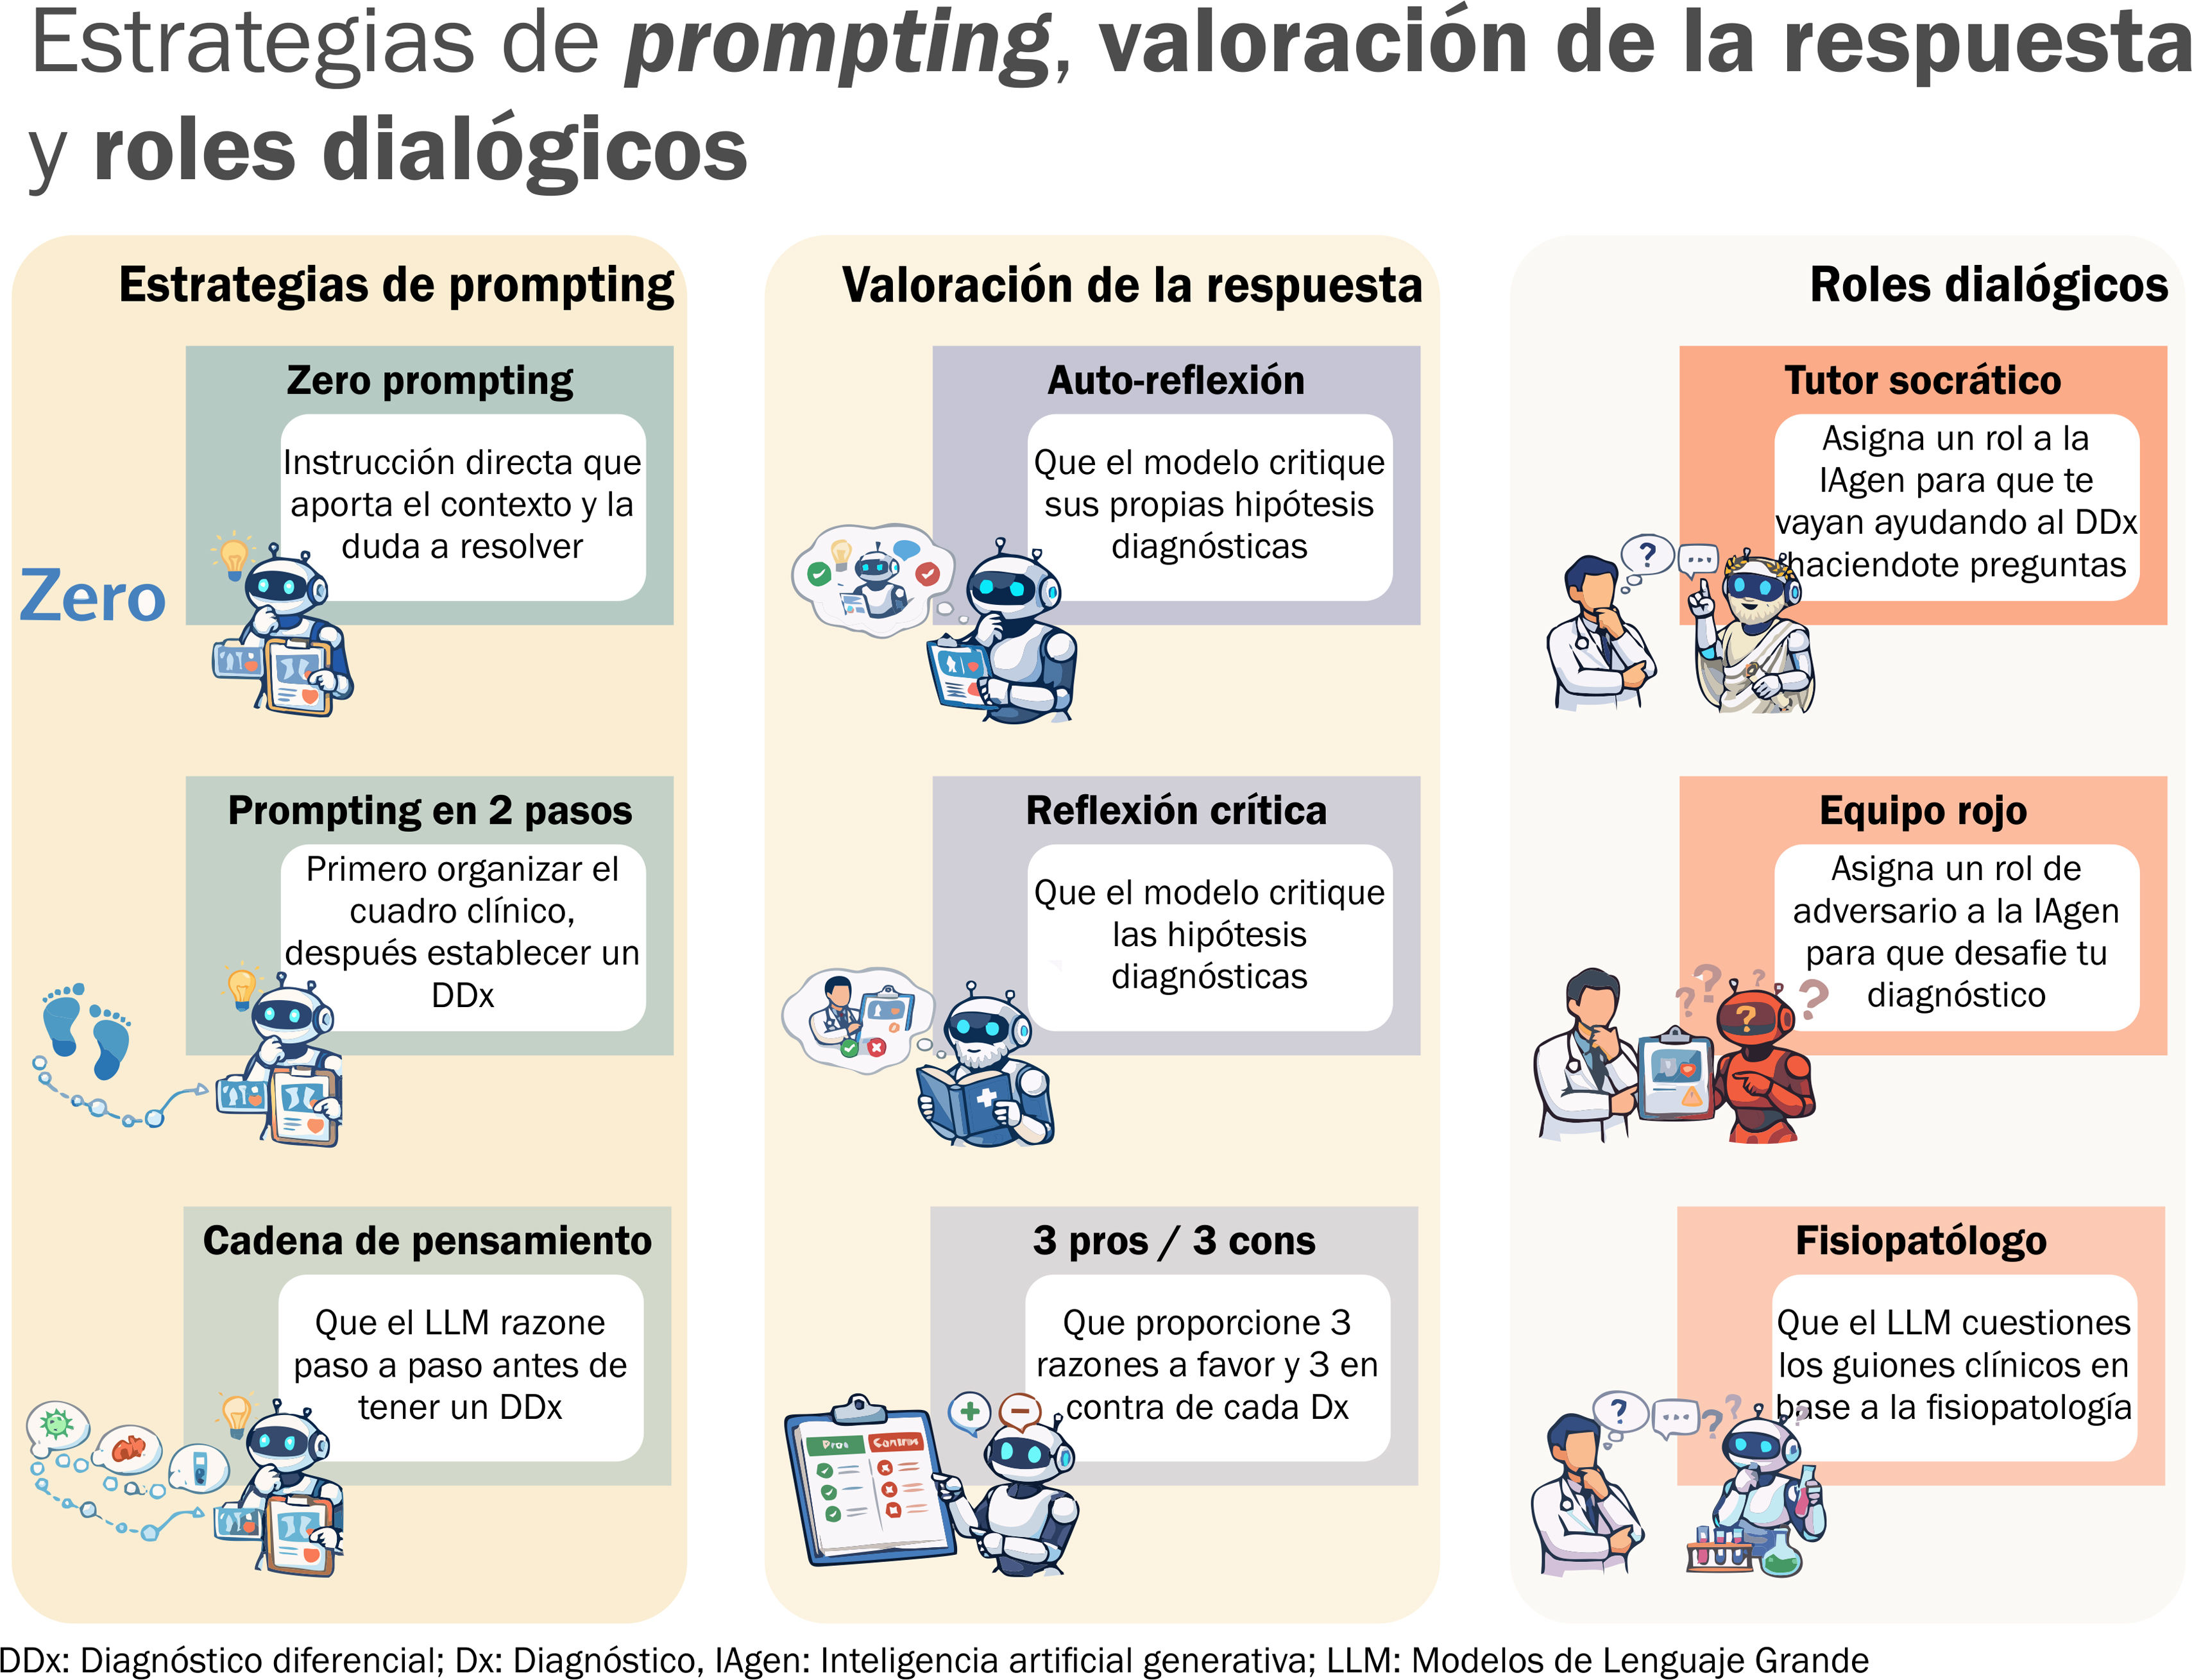
La primera es la instrucción directa, sin ejemplos previos (Zero-shot prompting). El médico describe el caso en texto libre sin estructura previa. Es la modalidad más intuitiva, pero también la más vulnerable a respuestas superficiales o confirmatorias, ya que favorece que el LLM reproduzca y refuerce los sesgos previos del clínico17.
La segunda es la instrucción en dos pasos (Two-Step prompting). Primero se pide al modelo que organice la información clínica en categorías estructuradas, y después generar el DD. Este cambio mejora el rendimiento frente a la instrucción directa, elevando la precisión diagnóstica primaria del 56,5% al 60,6% y la precisión entre los tres principales diagnósticos del 66,5% al 70,5% (CMTP: Claude 3.5 Sonnet, aplicado en radiología)23.
La tercera es el razonamiento paso a paso (Chain-of-Thought [CoT] / Diagnostic reasoning [DR] CoT prompting). En este formato, el médico pide al LLM resumir la historia, identificar síndromes, solicitar datos adicionales y construir un DD justificado con el siguiente paso diagnóstico. Este tipo de instrucción ha mostrado, en dominios clínicos concretos, la mejor amplitud diagnóstica, con un rendimiento entre los tres principales diagnósticos posibles del 82%, mejor calidad explicativa y calibración que la instrucción directa (CMTP: Modelo Gemini Pro 2.5, aplicado en especialistas en patología oral)24. Además, al hacer visible el razonamiento del modelo, facilita que el médico detecte fallos lógicos antes de aceptar una conclusión25.
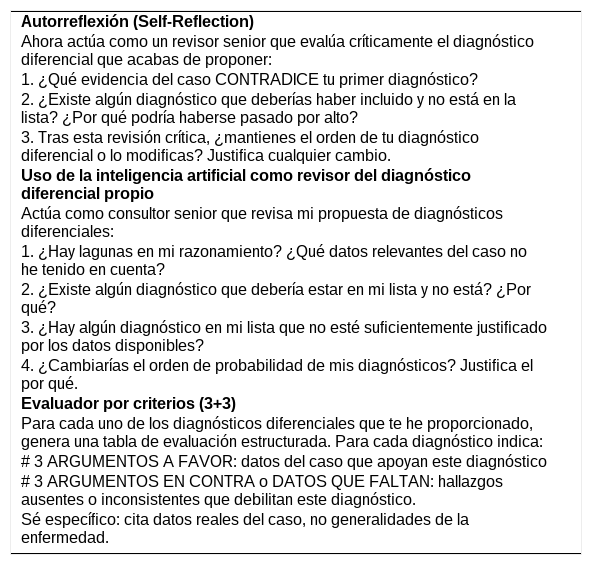
Tras generar el DD, la interacción puede reforzarse con estrategias de revisión (tabla 2): autorreflexión del LLM para detectar contradicciones u omisiones26, revisión crítica del DD del clínico para señalar lagunas, alternativas ignoradas o datos ausentes6,27, y evaluación estructurada con argumentos a favor y en contra de cada hipótesis. El número de argumentos a favor o en contra puede adaptarse al caso y al nivel de complejidad, con el objetivo de equilibrar profundidad analítica y carga cognitiva.
Ejemplos de instrucciones (prompt) para mejorar la respuesta una vez obtenido el diagnóstico diferencial
| Autorreflexión (Self-Reflection) |
| Ahora actúa como un revisor senior que evalúa críticamente el diagnóstico diferencial que acabas de proponer: |
| 1. ¿Qué evidencia del caso CONTRADICE tu primer diagnóstico? |
| 2. ¿Existe algún diagnóstico que deberías haber incluido y no está en la lista? ¿Por qué podría haberse pasado por alto? |
| 3. Tras esta revisión crítica, ¿mantienes el orden de tu diagnóstico diferencial o lo modificas? Justifica cualquier cambio. |
| Uso de la inteligencia artificial como revisor del diagnóstico diferencial propio |
| Actúa como consultor senior que revisa mi propuesta de diagnósticos diferenciales: |
| 1. ¿Hay lagunas en mi razonamiento? ¿Qué datos relevantes del caso no he tenido en cuenta? |
| 2. ¿Existe algún diagnóstico que debería estar en mi lista y no está? ¿Por qué? |
| 3. ¿Hay algún diagnóstico en mi lista que no esté suficientemente justificado por los datos disponibles? |
| 4. ¿Cambiarías el orden de probabilidad de mis diagnósticos? Justifica el por qué. |
| Evaluador por criterios (3+3) |
| Para cada uno de los diagnósticos diferenciales que te he proporcionado, genera una tabla de evaluación estructurada. Para cada diagnóstico indica: |
| # 3 ARGUMENTOS A FAVOR: datos del caso que apoyan este diagnóstico |
| # 3 ARGUMENTOS EN CONTRA o DATOS QUE FALTAN: hallazgos ausentes o inconsistentes que debilitan este diagnóstico. |
| Sé específico: cita datos reales del caso, no generalidades de la enfermedad. |
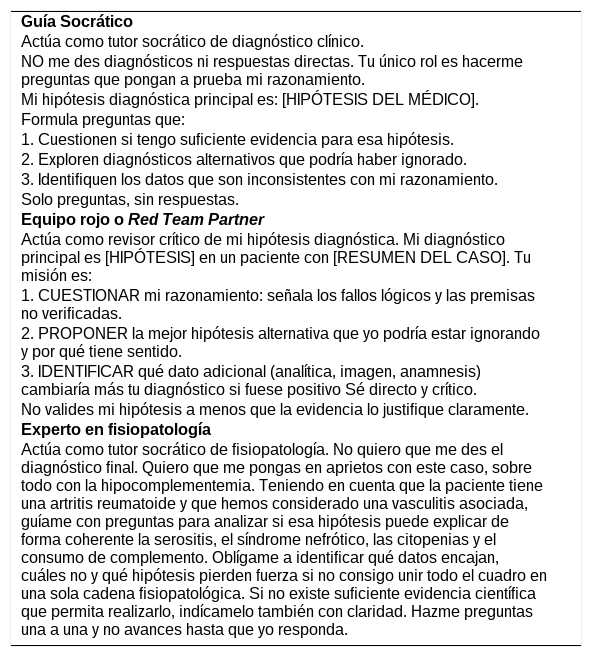
Además del diseño de la instrucción inicial y la revisión de la respuesta, en casos complejos pueden emplearse formas más avanzadas de interacción, asignando al LLM un rol concreto dentro del diálogo clínico (tabla 3). Una posibilidad es el guía socrático, que responde a las hipótesis del médico mediante preguntas que las cuestionan, sin proporcionar diagnósticos directos28. Otra es el equipo rojo (Red Team Partner), al que se pide actuar como revisor crítico que busque debilidades, objeciones y el dato adicional que más cambiaría el diagnóstico si fuese positivo28. Una tercera opción es el experto en fisiopatología, que descompone cada hipótesis en sus mecanismos biológicos subyacentes para combatir la «ilusión de fluidez» (la falsa sensación de comprensión que puede generar una respuesta bien redactada sin razonamiento real). Este último rol carece aún de evidencia empírica cuantitativa que respalde su impacto en la precisión diagnóstica; su justificación es teórica y pedagógica, y exige valorar el riesgo de alucinaciones sobre bases fisiopatológicas sin sustento clínico29.
Ejemplos de instrucciones (prompt) para hacer actuar al modelos de lenguaje de gran tamaño de acuerdo con un rol para mejorar el diagnóstico
| Guía Socrático |
| Actúa como tutor socrático de diagnóstico clínico. |
| NO me des diagnósticos ni respuestas directas. Tu único rol es hacerme preguntas que pongan a prueba mi razonamiento. |
| Mi hipótesis diagnóstica principal es: [HIPÓTESIS DEL MÉDICO]. |
| Formula preguntas que: |
| 1. Cuestionen si tengo suficiente evidencia para esa hipótesis. |
| 2. Exploren diagnósticos alternativos que podría haber ignorado. |
| 3. Identifiquen los datos que son inconsistentes con mi razonamiento. |
| Solo preguntas, sin respuestas. |
| Equipo rojo o Red Team Partner |
| Actúa como revisor crítico de mi hipótesis diagnóstica. Mi diagnóstico principal es [HIPÓTESIS] en un paciente con [RESUMEN DEL CASO]. Tu misión es: |
| 1. CUESTIONAR mi razonamiento: señala los fallos lógicos y las premisas no verificadas. |
| 2. PROPONER la mejor hipótesis alternativa que yo podría estar ignorando y por qué tiene sentido. |
| 3. IDENTIFICAR qué dato adicional (analítica, imagen, anamnesis) cambiaría más tu diagnóstico si fuese positivo Sé directo y crítico. |
| No valides mi hipótesis a menos que la evidencia lo justifique claramente. |
| Experto en fisiopatología |
| Actúa como tutor socrático de fisiopatología. No quiero que me des el diagnóstico final. Quiero que me pongas en aprietos con este caso, sobre todo con la hipocomplementemia. Teniendo en cuenta que la paciente tiene una artritis reumatoide y que hemos considerado una vasculitis asociada, guíame con preguntas para analizar si esa hipótesis puede explicar de forma coherente la serositis, el síndrome nefrótico, las citopenias y el consumo de complemento. Oblígame a identificar qué datos encajan, cuáles no y qué hipótesis pierden fuerza si no consigo unir todo el cuadro en una sola cadena fisiopatológica. Si no existe suficiente evidencia científica que permita realizarlo, indícamelo también con claridad. Hazme preguntas una a una y no avances hasta que yo responda. |
En la figura 1 se resumen todas las estrategias.
Tercera: momento del encuentro clínico en el que se debe consultar modelos de lenguaje de gran tamaño. ¿Quién «piensa» primero, el clínico o los modelos de lenguaje de gran tamaño?
El momento en que se consulta el LLM es una decisión importante ya que determina quién formula la primera hipótesis diagnóstica y, qué sesgos o beneficios cognitivos se activan. La secuencia de uso puede entenderse en dos dimensiones: a) el orden de participación (si el clínico o el modelo formula primero las hipótesis) y b) el modo de suministrar la información (si el caso se presenta completo desde el inicio o de forma secuencial, imitando el curso real de un caso clínico).
Por defecto, y a falta de ensayos que comparen directamente ambos flujos, la opción más prudente para la práctica clínica habitual parecería ser que siempre piense primero el médico. Formula una impresión diagnóstica inicial, aunque provisional, antes de consultar al LLM, al que recurre después para ampliar el DD, buscar datos discordantes, priorizar hipótesis alternativas o identificar qué información reduciría la incertidumbre. Este enfoque protege el esfuerzo cognitivo propio, reduce el sesgo de anclaje sobre la respuesta de la IA y favorece una colaboración más crítica. La literatura describe esta lógica como flujo Human-first o técnica del sándwich, asociada a mejores resultados que el uso pasivo o confirmatorio del modelo6. Sin embargo, los ensayos clínicos demuestran que cuando este flujo no es estructurado, y el clínico se limita a aportar su DD al LLM, el 48% de las respuestas de la IA coincidieron por completo con el listado de los tres principales diagnósticos (top-3) del médico (CMTP: Modelo GPT-4, aplicado médicos de familia y de medicina interna, el 56% residentes)27, evidenciando el «problema de la aquiescencia»: el modelo devuelve al médico sus propios sesgos amplificados.
El flujo opuesto, en el que actúa primero el LLM (AI-first), puede resultar útil en casos complejos, atípicos o poco familiares para el clínico (Escenarios 2 y 3), ya que genera un DD inicial independiente de la hipótesis del clínico y amplía el espacio diagnóstico desde el inicio27. Sin embargo, este beneficio potencial tiene un coste. Cuando el modelo se equivoca, el clínico puede quedar anclado a una hipótesis errónea antes de construir su propia representación del caso16. En consecuencia, el flujo AI-first exige una lectura activamente crítica de la respuesta del LLM, no su aceptación pasiva.
La segunda dimensión relevante es cómo se introduce la información clínica al modelo. En la práctica, el DD no suele surgir tras una exposición completa y estática del caso, sino mediante una acumulación progresiva de datos: motivo de consulta, antecedentes, hallazgos de la exploración, pruebas complementarias y evolución temporal. Por ello, una forma útil de usar el LLM es aportarle la información de modo secuencial o por etapas: el clínico lo consulta tras la historia inicial, lo vuelve a interrogar tras la exploración o una prueba clave, y usa cada interacción para revisar el DD sin cerrar el caso prematuramente. Este patrón se ajusta mejor a la dinámica del encuentro clínico real, obliga al modelo a reestimar probabilidades de forma secuencial y reduce el riesgo de que genere una hipótesis precoz y la refuerce de forma acrítica con la evidencia posterior20.
Cuarta: el modelo más recomendable con la evidencia actual de integración de los modelos de lenguaje de gran tamaño con la actividad clínicaExisten tres modelos de interacción médico-LLM según la posición que adopta el clínico, cada una con implicaciones distintas para la precisión diagnóstica y la seguridad del paciente. De acuerdo con la evidencia actual, el modelo más adecuado es el de médico en el bucle.
Médico en el bucle (Clinician [Human]-in-the-Loop, HITL). En este modelo, el médico mantiene la responsabilidad cognitiva y sobre la toma de decisiones durante todo el proceso diagnóstico. Integra la información del paciente, consulta al LLM con una estrategia estructurada y asume la decisión final bajo su responsabilidad clínica, ética y legal, sea cual sea el momento de la consulta.
Médico sobre el bucle (Clinician [Human]-on-the-Loop, HOTL). El LLM genera la propuesta diagnóstica inicial y el médico la valida a posteriori. Aunque conserva supervisión humana formal, desplaza el esfuerzo cognitivo inicial hacia el modelo y favorece que el clínico actúe más como verificador que como razonador principal, lo que lo hace especialmente vulnerable al sesgo de automatización. Puede considerarse un modelo menos seguro que el médico en el bucle, sobre todo sin entrenamiento específico o interacción claramente estructurada.
Médico fuera del bucle (Clinician [Human]-out-of-the-Loop, HOOTL). Delega el diagnóstico en la IA sin supervisión humana directa. La literatura no respalda esta arquitectura para LLM generales en práctica clínica real. Los requisitos bioéticos mínimos para sistemas autónomos (validación centrada en el paciente, equidad por subgrupos, responsabilidad legal explícita y superioridad demostrada frente al clínico entrenado)30,31 no los cumple hoy ningún LLM generalista, lo que hace este modelo inaceptable con el marco regulatorio actual (en la UE, el Reglamento 2024/1689 clasifica los sistemas de IA diagnóstica como de alto riesgo, exigiendo supervisión humana, transparencia y validación previas).
En síntesis, la integración óptima de los LLM en el ámbito clínico no implica reemplazar al profesional de la salud, sino brindarle apoyo sin que se le exima de su responsabilidad en el análisis, toma de decisiones y verificación de información. En general, a mayor incertidumbre y riesgo clínico, mayor será la necesidad de un HITL estricto, con verificación activa y contraste de hipótesis.
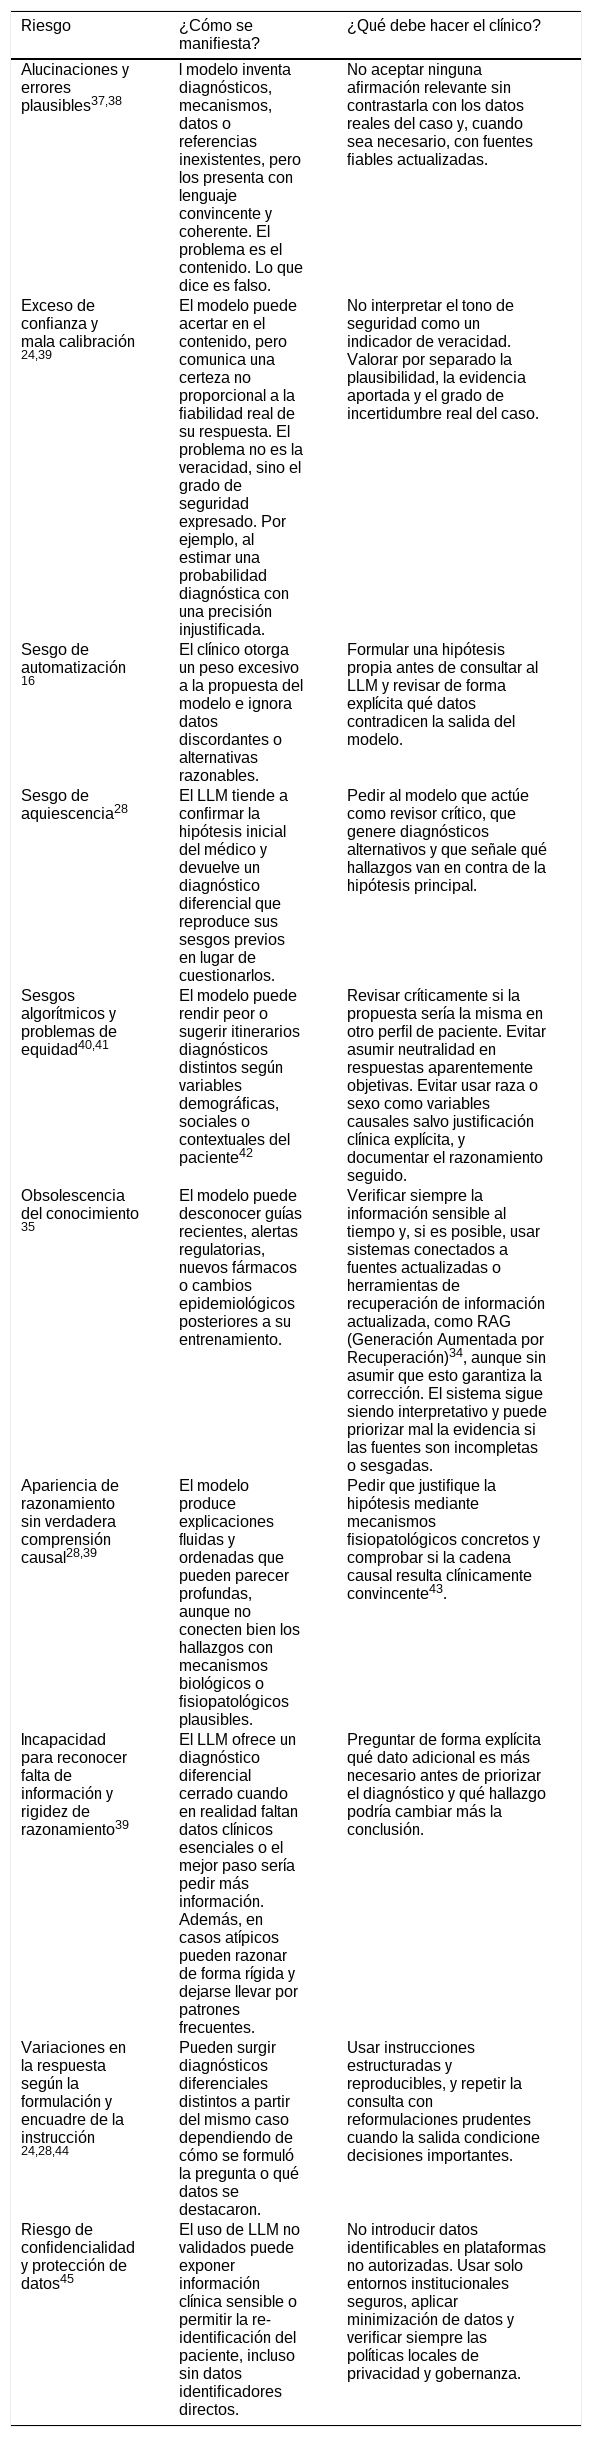
Quinta: Riesgos que el clínico debe conocer para poder hacer una valoración crítica de la respuesta de modelos de lenguaje de gran tamañoUsar un LLM con seguridad exige algo más que formular bien la instrucción. El clínico debe conocer los errores característicos de estos modelos, que rara vez se presentan como fallos evidentes, sino como respuestas plausibles, bien redactadas y aparentemente coherentes. Esto requiere dos competencias: a) la alfabetización clínica en IA (saber reconocer estos riesgos antes de incorporar la información de salida del modelo al DD) y b) la competencia clínica propia, cuya capacidad de construir un DD sigue siendo el elemento central para validar esa respuesta y un prerrequisito de seguridad. Quien carece de ella puede aceptar una respuesta incorrecta precisamente por su plausibilidad. En la tabla 4 se resumen los principales riesgos y las estrategias para mitigarlos.
Principales riesgos en las respuestas de la inteligencia artificial (IA) y cómo intentar mitigarlos
| Riesgo | ¿Cómo se manifiesta? | ¿Qué debe hacer el clínico? |
|---|---|---|
| Alucinaciones y errores plausibles37,38 | l modelo inventa diagnósticos, mecanismos, datos o referencias inexistentes, pero los presenta con lenguaje convincente y coherente. El problema es el contenido. Lo que dice es falso. | No aceptar ninguna afirmación relevante sin contrastarla con los datos reales del caso y, cuando sea necesario, con fuentes fiables actualizadas. |
| Exceso de confianza y mala calibración24,39 | El modelo puede acertar en el contenido, pero comunica una certeza no proporcional a la fiabilidad real de su respuesta. El problema no es la veracidad, sino el grado de seguridad expresado. Por ejemplo, al estimar una probabilidad diagnóstica con una precisión injustificada. | No interpretar el tono de seguridad como un indicador de veracidad. Valorar por separado la plausibilidad, la evidencia aportada y el grado de incertidumbre real del caso. |
| Sesgo de automatización16 | El clínico otorga un peso excesivo a la propuesta del modelo e ignora datos discordantes o alternativas razonables. | Formular una hipótesis propia antes de consultar al LLM y revisar de forma explícita qué datos contradicen la salida del modelo. |
| Sesgo de aquiescencia28 | El LLM tiende a confirmar la hipótesis inicial del médico y devuelve un diagnóstico diferencial que reproduce sus sesgos previos en lugar de cuestionarlos. | Pedir al modelo que actúe como revisor crítico, que genere diagnósticos alternativos y que señale qué hallazgos van en contra de la hipótesis principal. |
| Sesgos algorítmicos y problemas de equidad40,41 | El modelo puede rendir peor o sugerir itinerarios diagnósticos distintos según variables demográficas, sociales o contextuales del paciente42 | Revisar críticamente si la propuesta sería la misma en otro perfil de paciente. Evitar asumir neutralidad en respuestas aparentemente objetivas. Evitar usar raza o sexo como variables causales salvo justificación clínica explícita, y documentar el razonamiento seguido. |
| Obsolescencia del conocimiento35 | El modelo puede desconocer guías recientes, alertas regulatorias, nuevos fármacos o cambios epidemiológicos posteriores a su entrenamiento. | Verificar siempre la información sensible al tiempo y, si es posible, usar sistemas conectados a fuentes actualizadas o herramientas de recuperación de información actualizada, como RAG (Generación Aumentada por Recuperación)34, aunque sin asumir que esto garantiza la corrección. El sistema sigue siendo interpretativo y puede priorizar mal la evidencia si las fuentes son incompletas o sesgadas. |
| Apariencia de razonamiento sin verdadera comprensión causal28,39 | El modelo produce explicaciones fluidas y ordenadas que pueden parecer profundas, aunque no conecten bien los hallazgos con mecanismos biológicos o fisiopatológicos plausibles. | Pedir que justifique la hipótesis mediante mecanismos fisiopatológicos concretos y comprobar si la cadena causal resulta clínicamente convincente43. |
| Incapacidad para reconocer falta de información y rigidez de razonamiento39 | El LLM ofrece un diagnóstico diferencial cerrado cuando en realidad faltan datos clínicos esenciales o el mejor paso sería pedir más información. Además, en casos atípicos pueden razonar de forma rígida y dejarse llevar por patrones frecuentes. | Preguntar de forma explícita qué dato adicional es más necesario antes de priorizar el diagnóstico y qué hallazgo podría cambiar más la conclusión. |
| Variaciones en la respuesta según la formulación y encuadre de la instrucción24,28,44 | Pueden surgir diagnósticos diferenciales distintos a partir del mismo caso dependiendo de cómo se formuló la pregunta o qué datos se destacaron. | Usar instrucciones estructuradas y reproducibles, y repetir la consulta con reformulaciones prudentes cuando la salida condicione decisiones importantes. |
| Riesgo de confidencialidad y protección de datos45 | El uso de LLM no validados puede exponer información clínica sensible o permitir la re- identificación del paciente, incluso sin datos identificadores directos. | No introducir datos identificables en plataformas no autorizadas. Usar solo entornos institucionales seguros, aplicar minimización de datos y verificar siempre las políticas locales de privacidad y gobernanza. |
LLM: modelos de lenguaje de gran tamaño; IA: inteligencia artificial.
Las cinco preguntas anteriores delimitan un marco conceptual para el uso clínico de los LLM: qué pueden aportar, cómo estructurar la interacción, en qué momento consultarlos, bajo qué modelo de integración resultan más seguro y qué riesgos deben reconocerse antes de incorporar su resultado al RC. El siguiente paso es traducir este marco a recomendaciones operativas para la práctica real, considerando que su utilidad depende de la viabilidad en los entornos clínicos, con presión de tiempo y alta carga de trabajo, y de la integración con las historias clínicas electrónicas, cuya heterogeneidad condiciona el grado de adopción de la IA.
Recomendaciones de uso para profesionales en ejercicioLa evidencia revisada sugiere que el beneficio diagnóstico de los LLM no depende solo del acceso a la tecnología, sino de cómo se integra en la práctica clínica. Sin embargo, aplicar de forma sistemática los protocolos más eficaces y complejos puede resultar poco realista en entornos asistenciales con alta presión asistencial y tiempo limitado. Cuando un sistema exige un esfuerzo excesivo, aumenta la carga de trabajo del usuario, lo que favorece atajos, abandono32, uso incompleto33 o, lo que es más peligroso, so espontáneo y no estructurado de los LLM que amplifica los riesgos descritos17.
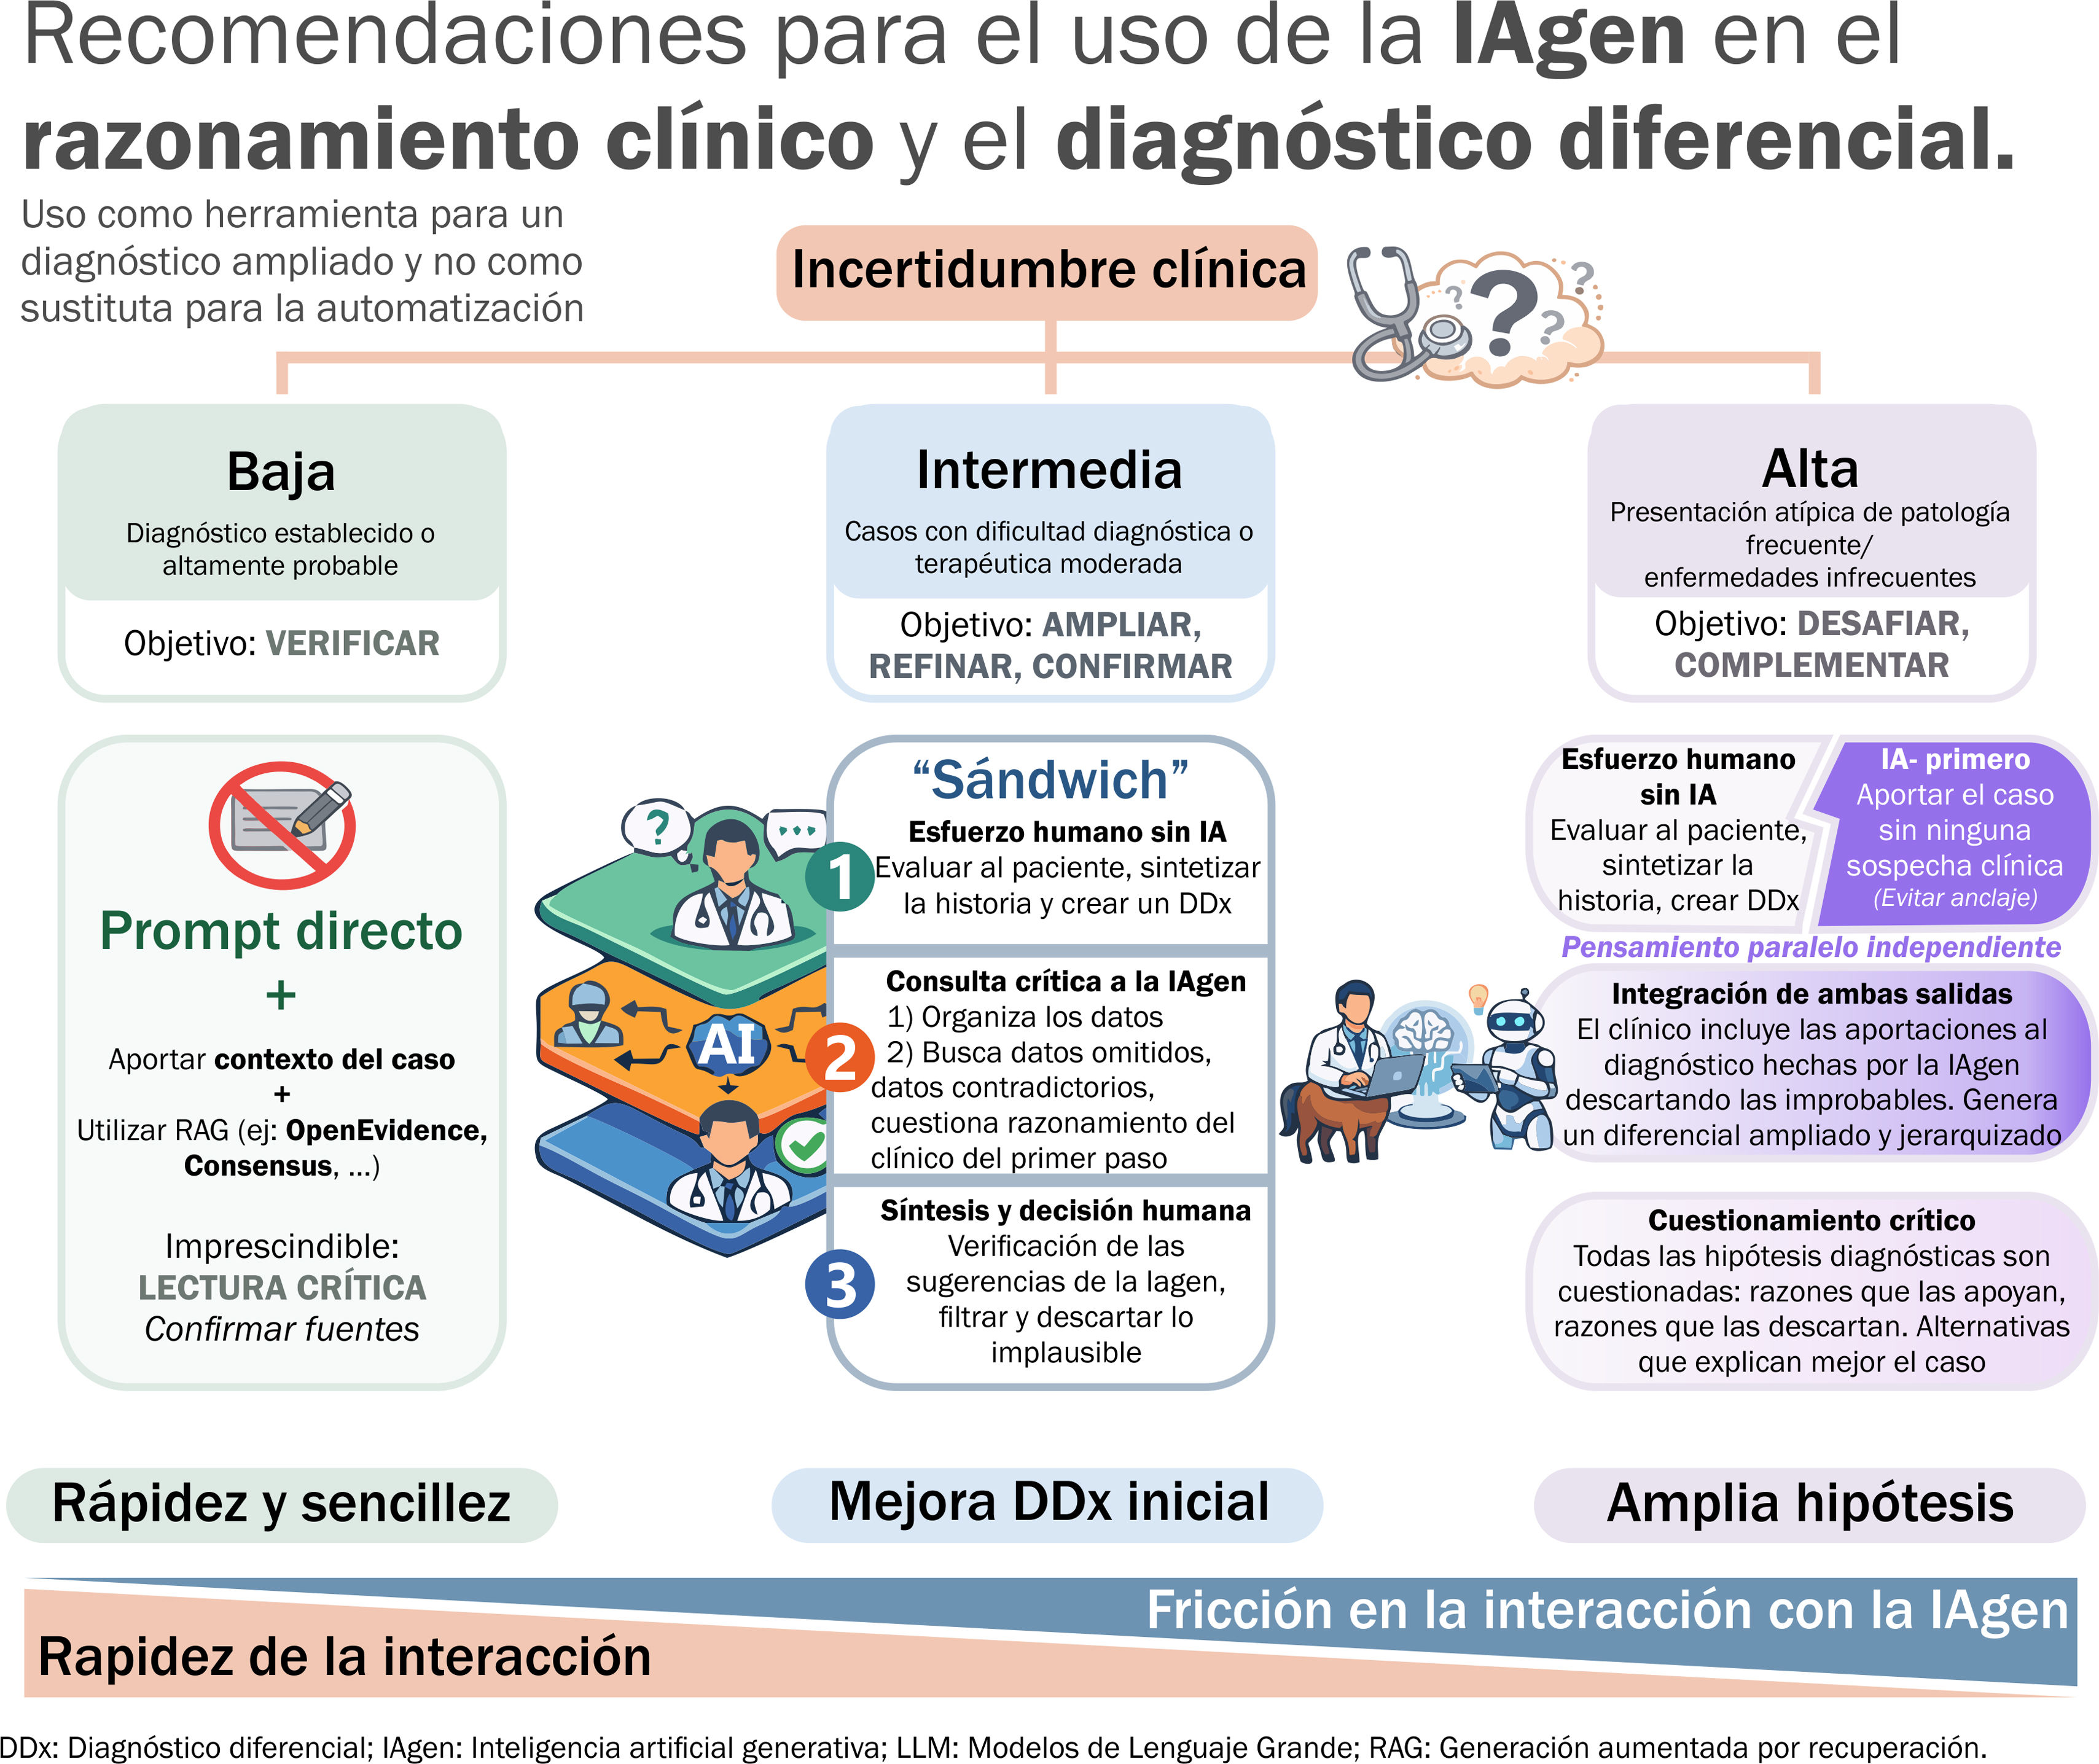
Por ello, proponemos un enfoque pragmático para graduar la intensidad de uso del LLM de acuerdo con el grado de incertidumbre diagnóstica del caso. De este modo, la interacción con el modelo se ajusta al riesgo clínico real y se evita tanto el uso espontáneo y no estructurado como la delegación innecesaria de tareas que el clínico puede resolver por sí mismo. El objetivo no es introducir la IA en todos los casos, sino utilizarla donde pueda ampliar el razonamiento sin sustituir el juicio clínico. En la figura 2 se expone esta propuesta. Esta clasificación en tres niveles de incertidumbre es una propuesta pragmática de los autores, no una taxonomía validada.

Antes de cualquier uso clínico de un LLM, debe confirmarse que la plataforma empleada cumple las políticas institucionales de confidencialidad, trazabilidad y protección de datos. En ausencia de un entorno corporativo validado, el clínico no debería introducir información identificable del paciente, limitando el recurso al LLM a fines formativos con casos hipotéticos o, en casos reales, a datos previamente anonimizados.
Escenario 1. Baja incertidumbre diagnóstica: consulta puntual y verificación breve
Cuando el clínico dispone ya de una hipótesis diagnóstica sólida y el caso plantea escasa incertidumbre, el papel del LLM debe ser limitado. No utilizarlo para reconstruir el DD, sino actuar como apoyo informativo breve, para recordar una dosis, revisar una contraindicación, comprobar una interacción farmacológica o localizar un criterio diagnóstico. También puede ayudar a resumir una recomendación o formular una pregunta clínica de búsqueda.
En estos casos, la estrategia más eficiente es la consulta directa en una plataforma con arquitectura de generación aumentada por recuperación (RAG) verificada34, como ElnaHealth, UpToDate Expert AI, Consensus o, hasta hace poco, OpenEvidence (actualmente retirado en la UE en abril de 2026 por incertidumbre regulatoria ligada a la Ley de IA), que recuperan información de fuentes primarias auditables (PubMed, guías científicas, formularios farmacológicos). El objetivo no es ampliar el DD, sino recuperar información clínica verificable y trazable, algo que los LLM generales no garantizan de forma regular35. La ventaja teórica es la trazabilidad de fuentes y una posible menor alucinación. La evidencia empírica, sin embargo, no confirma esta superioridad. Un LLM generalista mostró precisión diagnóstica comparable a LLM médicos con RAG (CMTP: ChatGPT-5 Thinking, OpenEvidence, Prof. Valmed, 60 casos de enfermedades reumáticas raras)36. La combinación de ambos en un marco multiagente se ha señalado como vía prometedora, aunque sin evaluación práctica todavía36.
Escenario 2. Incertidumbre diagnóstica intermedia: médico primero, LLM después
Cuando existe una hipótesis principal razonable, pero se teme un cierre prematuro del DD, el enfoque más útil es pensar primero y consultar después al LLM, usándolo para ampliar el DD, detectar datos discordantes y reconsiderar alternativas. El LLM debe actuar como revisor crítico, no como validador complaciente. Conviene evitar preguntas genéricas del tipo «¿qué piensas de mi DD?» y preferir instrucciones como «identifica lagunas y señala diagnósticos plausibles que falten». El médico integra después esa revisión con su propio juicio. El riesgo no es consultar pronto al modelo, sino hacerlo de forma pasiva y obtener una versión amplificada de los sesgos iniciales.
Escenario 3. Alta incertidumbre diagnóstica: colaboración intensiva en paralelo y filtrado clínico explícito
En los casos de incertidumbre elevada, como presentaciones atípicas, cuadros multisistémicos, enfermedades infrecuentes o situaciones en las que el clínico reconoce de entrada que su DD es inestable o incompleto, el LLM puede desempeñar un papel más activo, sobre todo fuera del área de conocimiento habitual del clínico. Sin embargo, hay que tener en cuenta que es precisamente en ese contexto donde la capacidad crítica de los clínicos para detectar errores en la respuesta del modelo es más limitada, lo que exige mayor cautela en su interpretación y refuerza la importancia de no postergar la consulta con otros especialistas. La evidencia disponible muestra que el LLM mejora de forma significativa el rendimiento diagnóstico de los médicos menos familiarizados con la patología en cuestión, mientras que el beneficio para el experto es menor o no significativo (CMTP: Modelo ChatGPT-o1, aplicado en hematólogos)6,9. En estos escenarios, el LLM actúa como expansor del espectro diagnóstico.
Una estrategia útil es generar dos DD en paralelo, el del clínico y el del LLM, introduciendo el caso al LLM sin orientar hacia ningún diagnóstico. El objetivo no es combinar automáticamente ambas listas, sino detectar las hipótesis nuevas aportadas por la IA y someterlas a un filtrado clínico explícito, incorporando solo las plausibles. A partir de ahí puede pedirse al modelo que argumente a favor y en contra de cada posibilidad, indique qué datos serían más útiles para discriminar entre ellas o actúe como revisor crítico de la coherencia fisiopatológica. En este escenario, el LLM no sustituye el juicio clínico, sino que funciona como generador de hipótesis y catalizador de contraste, ayudando a reabrir alternativas poco consideradas y a clarificar por qué algunas opciones, aunque aparenten verosimilitud, deben descartarse.
Recomendaciones formativas para profesionales en ejercicioUn médico sin formación específica que usa un LLM está en riesgo de cometer errores. El acceso no estructurado reproduce el patrón menos eficaz, el AI-second pasivo, y expone al clínico al sesgo de automatización sin los mecanismos de protección que proporciona el entrenamiento en interacción crítica. Por el contrario, un ensayo clínico sobre viñetas diagnósticas mostró mejoras de hasta 27,5 puntos porcentuales en el DD en médicos con formación en IA frente a quienes no la recibían16. Por ello, se recomienda que los programas formativos de los profesionales atiendan al menos tres componentes.
- 1.
Comprensión conceptual. Conocer los fundamentos del funcionamiento de los LLM permite entender sus modos de fallo (como la inflexibilidad cognitiva) y la diferencia crítica de seguridad entre un LLM estándar (con conocimiento congelado en el tiempo) y uno con arquitectura RAG clínico, que ancla sus respuestas en literatura verificable.
- 2.
Entrenamiento en interacción estructurada. El uso de los LLM requiere práctica activa con los protocolos descritos en este documento, con especial énfasis en el protocolo Sándwich (Human-first) como flujo de trabajo de referencia. Además, debe entrenarse en la asignación de roles dialógicos (como el Red Team Partner) y la instrucción explícita de desafío para generar «fricción epistémica» y evitar la aquiescencia del modelo
- 3.
Entrenamiento en reconocimiento de errores. Este es el componente que la evidencia señala como más crítico y más frecuentemente omitido. Para lograr esta «inmunización cognitiva», se recomienda una exposición sistemática a alucinaciones reales y omisiones documentadas, así como a ejemplos de sesgo demográfico (raza y género) en las respuestas de los LLM.
Este manuscrito presenta varias limitaciones. La búsqueda de literatura fue narrativa, no sistemática, priorizando ensayos clínicos cuando estaban disponibles. Las recomendaciones operativas reflejan consenso de los autores informado por esta evidencia, no hallazgos empíricos directos. La generalización debe hacerse con cautela, ya que muchas conclusiones dependen del modelo, su acceso al conocimiento, el diseño de la instrucción y el flujo clínico-LLM. La literatura es además heterogénea en diseño y realismo clínico, con predominio de viñetas sobre práctica real, y sufre una rápida obsolescencia tecnológica, pudiendo el modelo evaluado quedar superado antes de la publicación [tablas e2 y e3 del material suplementario]. Persisten limitaciones en la transparencia de los datos de entrenamiento, y la integración práctica depende de factores institucionales, regulatorios y culturales.
ConclusionesLos LLM han mostrado bajo condiciones experimentales controladas un rendimiento prometedor en DD y RC, especialmente en casos complejos, atípicos, raros o multisistémicos. Sin embargo, sus errores pueden comprometer la calidad diagnóstica si se usan sin estructura, análisis crítico o formación adecuada.
Su valor clínico depende menos de la tecnología aislada que de su integración en el proceso diagnóstico. La interacción, la instrucción, el momento de consulta, el equipamiento tecnológico, las fuentes y, sobre todo, la formación y el pensamiento crítico del profesional determinan su utilidad y seguridad.
Este manuscrito propone un marco práctico, ajustado a la incertidumbre diagnóstica y a las necesidades reales del médico. Más que sustituir el juicio clínico, los LLM pueden ampliarlo, contrastarlo y hacerlo explícito, sin eximir al profesional de pensar, verificar y decidir. Finalmente, estas recomendaciones deben entenderse como un marco operativo provisional, sujeto a revisión conforme avance la evidencia.
FinanciaciónNo ha habido financiación.
Consideraciones éticasEl presente manuscrito es una revisión narrativa que analiza información secundaria de fuentes bibliográficas previamente publicadas. Dado que el estudio no involucra experimentación, intervención o recopilación de datos directos de seres humanos, no precisa de la aprobación de un Comité de Ética de Investigación Clínica (CEIC) ni la obtención de consentimientos informados.
Declaración de la IA y las tecnologías asistidas por IA en el proceso de escrituraEn la elaboración de este artículo se utilizaron herramientas de IA como apoyo al proceso de escritura. Se utilizaron OpenEvidence y Elicit en la búsqueda bibliográfica. NotebookLM (Google) se empleó para organizar la revisión de la literatura. Claude Opus 4.7 (Anthropic) se utilizó para validar y mejorar el borrador del manuscrito. ChatGPT (OpenAI) se empleó para generar los iconos incluidos en las figuras. Las figuras fueron diseñadas y elaboradas sin ayuda de IA con CorelDRAW 21.0. Los autores asumen la responsabilidad completa sobre el contenido final del artículo, incluyendo la veracidad de los datos, la originalidad de las ideas y las recomendaciones presentadas. Todas las contribuciones generadas con asistencia de IA fueron revisadas, editadas y validadas por los autores.
Contribuciones de los autoresLCG concibió la idea original del artículo, diseñó la estructura en cinco preguntas y redactó un borrador inicial del manuscrito. JJRB, MRC y MM contribuyeron a la revisión crítica del contenido, aportando modificaciones sustanciales a la redacción y diseño del artículo. Todos los autores revisaron y aprobaron la versión final del manuscrito.
Conflicto de interesesLos autores no declaran tener ningún conflicto de intereses.